Resolução de Nomes: DNS na Era da Nuvem
por Frank de Alcantara em 24/08/2026
Os quatro artigos anteriores construíram o caminho até uma máquina. Nenhum deles perguntou como descobrimos qual máquina deve receber uma requisição.
Índice da Série: Redes para Engenharia de Software
- 1. A Pilha TCP/IP e a Física da Rede
- 2. Da Rede Local à Web: Dispositivos, Topologias e Serviços
- 3. Camada de Internet: IP, Endereçamento, Sub-redes e Encaminhamento
- 4. Transporte: TCP, UDP e QUIC
- 5. Resolução de Nomes: DNS na Era da Nuvem (Você está aqui)
A pergunta parece administrativa, mas não é. O sistema que a responde opera continuamente desde 1987 e atravessa fronteiras administrativas, provedores e continentes. Essa distribuição permite que partes inteiras falhem sem apagar todo o espaço de nomes. Porém, ela também introduz dependências capazes de fazer uma aplicação saudável parecer indisponível. As duas propriedades nascem do mesmo mecanismo: o DNS aceita respostas temporariamente antigas para continuar respondendo e expressa esse compromisso em um número que quase ninguém revisa.
O número tem nome, TTL, e este artigo é em boa parte sobre a aritmética dele. Vamos calcular a taxa de acerto do cache, o tempo esperado para uma mudança se propagar, a carga que uma redução de TTL despeja sobre a infraestrutura autoritativa e, principalmente, quanto tempo um serviço pode continuar indisponível depois que a verificação de saúde já detectou o problema.
Continuamos com a régua do Artigo 1: $\text{RTT} = 76{,}65$ ms entre São Paulo e Ashburn quando precisarmos de uma rota longa. O piso físico da Tabela 2 daquele artigo continua sendo o critério para rejeitar qualquer afirmação impossível sobre latência.
1. A hierarquia e a delegação
O espaço de nomes do DNS é uma árvore invertida. A raiz, escrita como um ponto solitário, tem filhos que são os domínios de topo, como com, org e br. Esses domínios têm filhos registrados, como example.com, e a árvore prossegue até nomes mais específicos. Um nome de domínio plenamente qualificado, ou FQDN, de Fully Qualified Domain Name, identifica o caminho completo até a raiz. Em www.example.com., lemos a especificidade da esquerda para a direita e a hierarquia da direita para a esquerda: www pertence a example, que pertence a com, que pertence à raiz. O ponto final representa essa raiz e faz parte do nome absoluto, embora interfaces quase sempre o omitam.
O que faz o sistema escalar não é apenas a árvore. É a delegação. Nenhum servidor conhece todos os nomes. Os servidores raiz sabem quais servidores respondem por cada domínio de topo. Os servidores de com, por sua vez, sabem quais servidores respondem por cada zona delegada abaixo deles. O servidor autoritativo de example.com é quem finalmente publica os conjuntos de registros daquela zona. Cada nível conhece o próximo, não o destino inteiro. Em 12 de setembro de 2026, os treze identificadores de servidores raiz correspondiam a $2045$ instâncias operacionais, mantidas por doze operadores independentes. O número de identificadores é pequeno. A implantação física não é.
Há três papéis que a leitora precisa separar, porque confundi-los produz diagnósticos errados a vida inteira.
O servidor autoritativo publica os dados de uma zona. Ele responde com autoridade sobre os nomes dessa zona e fornece delegações para zonas filhas. Não percorre a árvore em nome do cliente.
O resolvedor recursivo procura a resposta. Ele recebe a consulta do cliente, percorre a hierarquia, guarda em cache o que aprendeu e devolve o resultado. Pode ser o resolvedor do provedor de acesso, um serviço público configurado pela leitora ou um resolvedor interno de um cluster Kubernetes, que o Artigo 14 retomará.
O resolvedor cliente, chamado stub resolver nas especificações, é a biblioteca do sistema operacional que recebe o pedido da aplicação e o encaminha ao resolvedor recursivo. Ele costuma executar pouca lógica, mas seu cache e sua política local ainda alteram o tempo observado pela aplicação.
Três papéis, três responsabilidades
O autoritativo publica os dados de uma zona. Ele responde com autoridade sobre os nomes que administra e delega zonas filhas. Não percorre a árvore em nome de ninguém.
O recursivo percorre a árvore em nome do cliente. Pergunta à raiz, ao domínio de topo, ao autoritativo. Guarda o que aprendeu em cache e é ele que paga o custo de uma resolução fria.
O cliente (stub resolver) é a biblioteca do sistema operacional que recebe o pedido da aplicação e o encaminha ao recursivo. Ele também tem cache, e esse cache pode alterar o tempo que a aplicação observa.
A frase “o DNS não resolve” quase sempre significa “o recursivo não conseguiu responder”. A frase “o DNS está errado” quase sempre significa “o autoritativo publica um valor que não é o esperado”. A frase “o DNS está lento” quase sempre significa “o cliente pagou o custo de uma resolução fria”. Separar os três é o primeiro passo do diagnóstico.
Uma referência introduz um quarto objeto, o registro de cola, ou glue record. Se ns1.example.com é o servidor que informa o endereço de example.com, perguntar a ele pelo próprio endereço criaria uma dependência circular. A zona pai quebra o ciclo incluindo o registro A ou AAAA do servidor delegado na resposta de referência. A RFC 9471 exige que uma referência traga todos os registros de cola disponíveis para servidores que estejam dentro do domínio delegado ou marque a resposta como truncada quando o transporte não comportar todos eles.
A Figura 1 mostra o caminho completo de uma consulta inicialmente ausente dos caches, com os saltos e os tempos que a Seção 4 calculará.
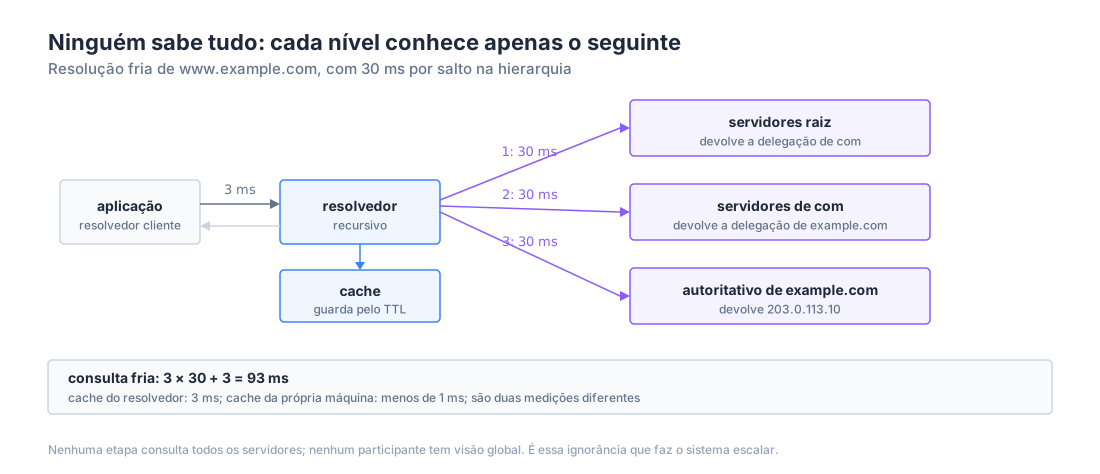 Figura 1: uma resolução inicialmente ausente dos caches custa 93 ms no modelo. O cache do resolvedor reduz o custo para 3 ms, enquanto o cache da própria máquina pode reduzi-lo para menos de 1 ms.
Note o que a figura não mostra, porque não existe. Nenhuma etapa contata todos os servidores. Nenhuma consulta é transmitida em broadcast. Nenhum componente tem visão global. O DNS escala porque cada participante sabe muito pouco e porque o resolvedor reutiliza o que aprendeu.
2. Tipos de registro e o que cada um decide
Uma zona é um conjunto de registros, e cada registro é uma tupla de nome, tipo, classe, TTL e dados. A classe é praticamente sempre IN, de Internet, e as outras existem por razões históricas que não interessam aqui. O tipo é o que decide o significado.
A Tabela 1 reúne os tipos que a engenheira de software encontra no dia a dia, com a decisão de engenharia que cada um materializa.
| Tipo | O que carrega | Decisão de engenharia que ele materializa |
|---|---|---|
A |
um endereço IPv4 | para qual máquina o tráfego vai |
AAAA |
um endereço IPv6 | o mesmo, na outra família de endereços |
CNAME |
outro nome | terceiriza a resposta, ao custo de uma resolução adicional |
NS |
os autoritativos de uma zona | onde a delegação aponta |
SOA |
parâmetros da zona | quem é o autoritativo primário e os tempos de sincronização |
MX |
destino de e-mail, com prioridade | para onde vai a mensagem, e em que ordem tentar |
TXT |
texto arbitrário | prova de posse, política de e-mail, verificação de terceiros |
SRV |
serviço, porta e alvo | descoberta de serviços com porta, usada por muitos protocolos |
CAA |
quais autoridades podem emitir certificado | restrição de emissão, verificada pela autoridade |
PTR |
nome a partir de endereço | resolução reversa, usada em registro e em reputação de e-mail |
Tabela 1: os tipos que a engenheira de software encontra. A coluna da direita é a razão de o tipo existir, enquanto a do meio é apenas o formato.
Um deles merece parágrafo próprio, porque é a fonte de um erro que a leitora vai cometer, ou vai revisar, mais cedo ou mais tarde.
O CNAME instrui o resolvedor a continuar a busca em outro nome. É extremamente útil porque permite apontar www.example.com para um nome administrado pelo provedor de nuvem. O provedor pode trocar endereços sem que a equipe precise editar a zona do cliente. O preço depende de quanto da nova hierarquia já está em cache, e a Seção 4 estabelece um limite superior explícito para esse custo.
A armadilha está na regra da RFC 1034: se existe um CNAME em um nó, nenhum outro dado pode coexistir naquele nó. A razão é semântica, não um capricho de implementação. Um CNAME afirma que o nome é um apelido canônico para outro nome. Se o mesmo nó também publicasse um endereço ou um servidor de e-mail, o resolvedor já não saberia se deveria usar os dados locais ou substituir o nome pelo alvo.
A consequência aparece no ápice da zona, chamado zone apex nas especificações, isto é, em example.com sem um rótulo mais específico à esquerda. O ápice precisa conter SOA e NS, pois é ali que a zona começa e que a delegação termina. Logo, o ápice não pode conter um CNAME. E é exatamente ali que muitas equipes querem apontar para o balanceador de carga do provedor.
A saída da indústria foi criar extensões de provedor, com nomes como ALIAS e ANAME. Elas aceitam outro nome na configuração, mas o servidor autoritativo devolve ao cliente um A ou AAAA comum. No Route 53, por exemplo, um registro de alias no ápice pode apontar somente para destinos admitidos pelo serviço e não é um CNAME disfarçado no protocolo. A solução resolve um problema real, mas tem duas consequências. A configuração deixa de ser portável entre provedores. Além disso, o TTL efetivo passa a depender do tipo de alvo e da política do provedor, que precisa ser verificada em vez de presumida.
A regra do CNAME no ápice
A RFC 1034 diz: se existe um
CNAMEem um nó, nenhum outro dado pode coexistir naquele nó. A razão é semântica, não capricho. UmCNAMEafirma que o nome é um apelido para outro nome. Se o mesmo nó também publicasse endereços ou registros de e-mail, o resolvedor não saberia se usa os dados locais ou se substitui o nome pelo alvo.O ápice da zona, como
example.com, precisa conterSOAeNS. Logo, não pode conterCNAME. E é exatamente ali que a maioria das equipes quer apontar para o balanceador de carga do provedor de nuvem.A saída da indústria foram extensões proprietárias com nomes como
ALIASeANAME. Elas aceitam outro nome na configuração, mas o autoritativo devolve ao cliente umAouAAAAcomum. No Route 53, um registro de alias no ápice só pode apontar para destinos admitidos pelo serviço.O preço é duplo: a configuração deixa de ser portável entre provedores, e o TTL efetivo passa a depender do tipo de alvo e da política do provedor. Verifique, não presuma.
2.1 Exercícios das Seções 1 e 2
1. Reconstrua uma resolução por delegações
O resolvedor precisa encontrar o registro A de www.example.com.. Seu cache está vazio. A raiz conhece os servidores de com, a zona com conhece os servidores de example.com e a zona example.com publica www.example.com. A 203.0.113.10. Indique, em ordem, cada consulta, cada resposta e o conhecimento adquirido.
Solução: A resolução começa com o nome completo, mas cada resposta intermediária entrega apenas a próxima autoridade.
| Passo | Conhecimento antes | Consulta | Resposta | Conhecimento depois |
|---|---|---|---|---|
| 1 | endereços dos servidores raiz | A www.example.com. para a raiz |
referência aos NS de com, com cola quando necessária |
servidores capazes de responder por com |
| 2 | servidores de com |
A www.example.com. para com |
referência aos NS de example.com, com cola quando necessária |
servidores autoritativos de example.com |
| 3 | autoritativos de example.com |
A www.example.com. para example.com |
203.0.113.10 com autoridade |
endereço pedido e TTL correspondente |
O resolvedor não pergunta primeiro por com, depois por example.com e somente então por www. Ele repete a consulta completa a servidores progressivamente mais específicos. As referências mudam quem poderá responder. O nome consultado permanece www.example.com..
2. Explique por que um registro de cola é necessário
A zona example.com declara ns1.example.com como seu servidor autoritativo. Mostre a dependência circular que surgiria se a zona com devolvesse apenas esse nome, sem um endereço de cola.
Solução: Para consultar example.com, o resolvedor precisa alcançar ns1.example.com. Porém, para descobrir o endereço de ns1.example.com, ele precisaria consultar a zona example.com, que é justamente a zona ainda inalcançável.
| Objetivo | Informação necessária | Onde estaria a informação sem cola |
|---|---|---|
consultar example.com |
endereço de ns1.example.com |
dentro de example.com |
consultar o endereço de ns1.example.com |
alcançar um autoritativo de example.com |
depende do endereço procurado |
A zona pai quebra o ciclo ao incluir o A ou AAAA do servidor de nomes na referência. Esse registro não transfere autoridade sobre o endereço para a zona pai. Ele fornece apenas o dado de partida necessário para alcançar a zona filha.
3. Audite um CNAME no ápice
Uma equipe pretende publicar os três registros abaixo. Determine se a configuração é válida e proponha uma alternativa para apontar o domínio a um balanceador gerenciado.
example.com.  300  IN  SOA    ns1.example.net. hostmaster.example.com. 2026091201 3600 600 86400 300
example.com.  300  IN  NS     ns1.example.net.
example.com.  300  IN  CNAME  lb.example-cloud.net.
Solução: Os três registros têm o mesmo proprietário, example.com.. Nesse nó, SOA e NS são obrigatórios para o ápice da zona, enquanto CNAME não pode coexistir com outros dados. A configuração é inválida, independentemente de o alvo do CNAME existir.
Uma alternativa é usar o tipo de alias oferecido pelo provedor, desde que o destino seja admitido, ou publicar endereços A e AAAA estáveis fornecidos por uma camada própria. A primeira opção troca portabilidade por integração. A segunda preserva o protocolo padrão, mas transfere à equipe a responsabilidade de manter os endereços corretos.
4. Escolha o registro que materializa cada decisão
Associe cada necessidade ao tipo de registro adequado: publicar um endereço IPv6, encaminhar e-mail com prioridade, descobrir uma porta de serviço e restringir autoridades certificadoras.
Solução: Cada necessidade pede um formato diferente porque os consumidores precisam interpretar dados distintos.
| Necessidade | Tipo | Dado decisivo |
|---|---|---|
| publicar um endereço IPv6 | AAAA |
os 128 bits do endereço |
| encaminhar e-mail com prioridade | MX |
preferência e nome do servidor de e-mail |
| descobrir uma porta de serviço | SRV |
prioridade, peso, porta e alvo |
| restringir autoridades certificadoras | CAA |
propriedade, sinalizador e valor autorizado |
Um TXT poderia carregar texto parecido com qualquer uma dessas informações, mas não forneceria a semântica padronizada que o consumidor espera. O tipo não é apenas embalagem. Ele determina como o dado participa do protocolo.
5. Diferencie autoridade, recursão e cliente
Uma aplicação consulta a biblioteca do sistema operacional, que envia a pergunta a 192.0.2.53. Esse servidor consulta a raiz, com e example.com. Classifique os três papéis e indique qual deles guarda a resposta para consultas posteriores.
Solução: A biblioteca do sistema operacional é o resolvedor cliente. O servidor 192.0.2.53 é o resolvedor recursivo, pois percorre a hierarquia em nome da aplicação. Os servidores de raiz, com e example.com são autoritativos para zonas diferentes e respondem sobre seus próprios dados ou delegações.
| Componente | Papel | Percorre a hierarquia | Pode manter cache |
|---|---|---|---|
| biblioteca do sistema operacional | resolvedor cliente | não | sim, conforme a política local |
192.0.2.53 |
resolvedor recursivo | sim | sim |
servidores de raiz, com e example.com |
servidores autoritativos | não | não para resolver em nome do cliente |
O cache principal da narrativa está no resolvedor recursivo, mas o cliente também pode guardar a resposta. É essa segunda cópia que explicará, na Seção 6, por que observar o TTL apenas no autoritativo não basta para prever o comportamento de uma aplicação.
3. Cache e TTL: o compromisso quantificado
Cada registro carrega um TTL, de Time To Live (tempo de vida), em segundos. Ele é uma instrução do autoritativo para quem armazenar a resposta: pode usar este valor por até tantos segundos sem me perguntar de novo.
A formulação que interessa é outra, e é desconfortável: o TTL é a janela de inconsistência que a organização aceita. Durante esse intervalo, resolvedores no mundo inteiro podem responder um valor que o dono da zona já mudou, e o DNS convencional não oferece um mecanismo geral para avisá-los. Há expiração, não invalidação distribuída.
O TTL não invalida, apenas expira
Quando você reduz o TTL de um registro, as cópias já armazenadas continuam válidas pelo TTL antigo que receberam quando foram guardadas. O autoritativo não tem como avisar os resolvedores de que o valor mudou. O DNS convencional não oferece invalidação distribuída.
Isso significa que o procedimento correto para uma migração tem duas esperas, não uma:
- Reduzir o TTL e esperar o TTL antigo inteiro, para que todas as cópias com o valor anterior expirem.
- Só então alterar o registro. Agora a propagação é governada pelo TTL novo, que é curto.
Quem pula a primeira espera descobre que uma fração dos resolvedores ainda serve o valor antigo por mais uma hora, exatamente o valor que a equipe achava ter desativado ao reduzir o TTL.
Vamos quantificar as duas pontas do compromisso.
A taxa de acerto do cache. Suponha consultas chegando a um resolvedor segundo um processo de Poisson de taxa $\lambda$, medida em consultas por segundo, para um registro com TTL igual a $T$ segundos. A consulta que encontra o cache vazio inicia um ciclo. Depois dela, o registro permanece válido durante $T$ segundos e recebe, em média, $\lambda T$ consultas atendidas pelo cache. Portanto, o ciclo esperado contém uma consulta que falha no cache e $\lambda T$ que acertam. A taxa de acerto $h$ será dada por
\[h = \frac{\lambda T}{1 + \lambda T}.\]Para $\lambda = 1$ consulta por segundo e $T = 300$ s, $h = 300/301 = 99{,}67\%$. A Tabela 2 mostra o comportamento em uma faixa útil.
| $\lambda$ (consultas/s) | $T = 30$ s | $T = 60$ s | $T = 300$ s | $T = 3600$ s |
|---|---|---|---|---|
| $0{,}1$ | $75{,}00\%$ | $85{,}71\%$ | $96{,}77\%$ | $99{,}72\%$ |
| $1$ | $96{,}77\%$ | $98{,}36\%$ | $99{,}67\%$ | $99{,}97\%$ |
| $10$ | $99{,}67\%$ | $99{,}83\%$ | $99{,}97\%$ | $100{,}00\%$ |
Tabela 2: taxa de acerto do cache, $h = \lambda T/(1 + \lambda T)$. Passar de 300 s para 3600 s ganha, na linha do meio, três décimos de ponto percentual e multiplica por doze a janela de inconsistência.
Leia a linha do meio da direita para a esquerda. De $3600$ para $300$ segundos, a taxa de acerto cai de $99{,}97\%$ para $99{,}67\%$, uma perda de $0{,}30$ ponto percentual. De $300$ para $60$, cai para $98{,}36\%$, uma perda de $1{,}31$ ponto. De $60$ para $30$, cai para $96{,}77\%$. Para um nome consultado uma vez por segundo, o retorno é fortemente decrescente acima de alguns minutos. Nesse regime, TTLs longos compram pouco desempenho adicional e ampliam muito a janela de inconsistência. A primeira linha lembra o limite da conclusão: nomes raros ainda ganham acertos relevantes quando o TTL cresce.
A propagação. Quando o valor muda, cada resolvedor continua servindo o anterior até sua cópia expirar. Se os instantes de expiração estiverem uniformemente distribuídos, uma hipótese útil para muitos resolvedores independentes, a fração ainda desatualizada no instante $t$ após a mudança será dada por
\[f(t) = 1 - \frac{t}{T}, \qquad 0 \le t \le T,\]com espera média de $T/2$ e pior caso de $T$. A Figura 2 mostra as curvas.
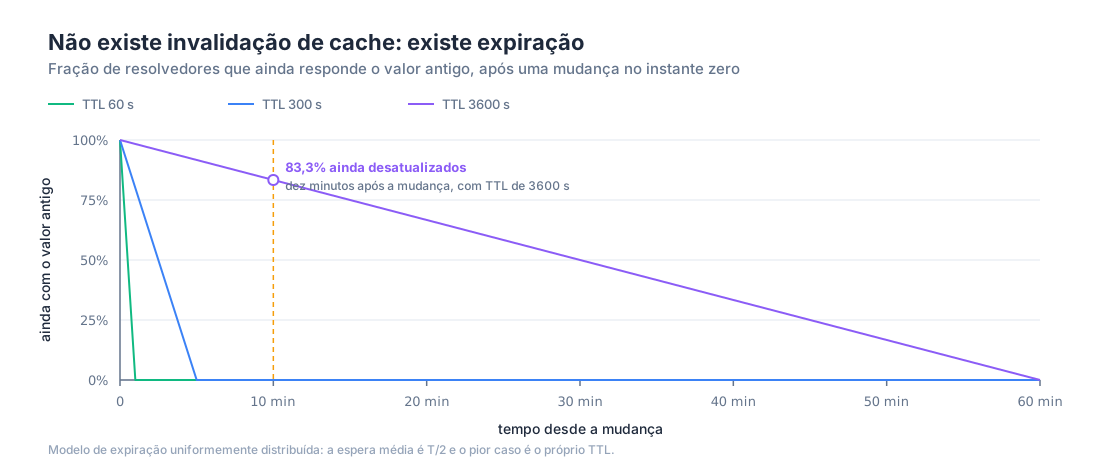 Figura 2: sob a hipótese de expirações uniformemente distribuídas, a convergência é linear e o pior caso é o próprio TTL. Com 3600 s, metade dos resolvedores ainda responde o valor anterior trinta minutos depois da mudança.
A conta que ninguém faz. Reduzir o TTL não é grátis, e o custo aparece no autoritativo. Se há demanda contínua pelo nome, cada resolvedor ativo consulta aproximadamente uma vez por TTL. A taxa agregada, com $N$ resolvedores independentes nesse regime, é $N/T$. Para um milhão de resolvedores:
| TTL | Consultas por segundo ao autoritativo |
|---|---|
| $3600$ s | $278$ |
| $300$ s | $3333$ |
| $30$ s | $33\,333$ |
Tabela 3: carga no autoritativo com um milhão de resolvedores continuamente ativos. Dentro desse modelo, reduzir o TTL por dez multiplica a carga por dez.
Daí sai um procedimento de migração que vale memorizar. Antes de mudar o destino, reduza o TTL e espere pelo menos o TTL antigo inteiro, para que as cópias conformes do valor antigo expirem. Só então mude o registro, agora com uma janela de cache menor. Depois de confirmar a mudança por resolvedores independentes, restaure o TTL. Quem esquece a primeira espera pode descobrir, no meio da migração, que uma fração dos resolvedores permanece presa ao valor antigo por mais uma hora, com o TTL que foi reduzido tarde demais. Políticas locais que impõem um TTL mínimo continuam fora dessa garantia e precisam ser medidas.
3.1 O cache também guarda ausências
O cache não armazena apenas endereços encontrados. Ele também pode guardar uma resposta autoritativa que afirma que um nome não existe ou que o nome existe, mas não possui o tipo pedido. Esse cache negativo impede que cada repetição de um erro de digitação ou cada busca automática por um tipo ausente atravesse novamente a hierarquia.
As duas ausências não são equivalentes. NXDOMAIN informa que o nome consultado não existe. NODATA informa que o nome existe, mas não possui um conjunto de registros do tipo solicitado. Se www.example.com possui apenas A, uma consulta por AAAA pode receber NODATA. Uma consulta por wwww.example.com, com um w excedente, pode receber NXDOMAIN.
A RFC 2308 determina que a resposta negativa autoritativa carregue o registro SOA da zona na seção de autoridade. O TTL do cache negativo será o menor valor entre o TTL desse SOA e o campo MINIMUM contido nele. Se ambos valem $300$ s, um nome criado logo depois de uma resposta NXDOMAIN ainda poderá parecer inexistente por até cinco minutos para quem guardou a ausência.
| Resposta | O que está ausente | Chave conceitual do cache | Consequência de uma mudança imediata |
|---|---|---|---|
NXDOMAIN |
o próprio nome | nome e classe | criar qualquer tipo no nome pode permanecer invisível até o TTL negativo expirar |
NODATA |
o tipo pedido | nome, tipo e classe | adicionar aquele tipo pode permanecer invisível até o TTL negativo expirar |
Tabela 4: o cache negativo reduz carga para ausências repetidas, mas também retarda a visibilidade de um nome ou tipo recém-criado.
A consequência operacional é a mesma que encontramos no cache positivo, mas costuma surpreender mais. Corrigir o registro no autoritativo não apaga a ausência já armazenada. Antes de lançar um nome novo que recebeu consultas de teste, precisamos verificar também o TTL negativo da zona.
3.2 Exercícios da Seção 3
1. Calcule a taxa de acerto do cache para três TTLs
Com $\lambda = 1$ consulta por segundo, calcule a taxa de acerto do cache para TTLs de $60$, $300$ e $3600$ segundos.
Solução: Para cada TTL, vamos substituir $\lambda=1$ em $h = \lambda T/(1 + \lambda T)$:
\[h_{60} = \frac{60}{61} = 98{,}36\%, \qquad h_{300} = \frac{300}{301} = 99{,}67\%, \qquad h_{3600} = \frac{3600}{3601} = 99{,}97\%.\]Multiplicar o TTL por sessenta, de $60$ para $3600$ segundos, melhorou a taxa de acerto em $1{,}61$ ponto percentual. A aproximação $h \approx 1 - 1/(\lambda T)$ dá $98{,}33\%$, $99{,}67\%$ e $99{,}97\%$. Ela funciona quando $\lambda T \gg 1$, mas falha quando o registro é consultado raramente, como mostra a primeira linha da Tabela 2.
2. Determine o efeito de uma consulta rara
Um registro é consultado uma vez a cada dez segundos, isto é, $\lambda = 0{,}1$. Recalcule a taxa de acerto do cache para os mesmos três TTLs e explique a diferença.
Solução: Agora $\lambda T$ vale $6$, $30$ e $360$:
\[h_{60} = \frac{6}{7} = 85{,}71\%, \qquad h_{300} = \frac{30}{31} = 96{,}77\%, \qquad h_{3600} = \frac{360}{361} = 99{,}72\%.\]A taxa de acerto depende do produto $\lambda T$, e não do TTL isoladamente. Com $T=60$ s, o registro raro acerta $85{,}71\%$ das consultas. Com $T=3600$ s, acerta $99{,}72\%$. O aumento reduz as falhas no cache de $14{,}29\%$ para $0{,}28\%$, portanto o efeito sobre a carga externa é grande. O preço também é grande: a janela máxima de inconsistência cresce de um minuto para uma hora. Para registros raros, precisamos calcular as duas pontas em vez de repetir a regra de que um TTL longo quase não ajuda.
3. Calcule o tempo de propagação de uma mudança
Com TTL de $3600$ segundos e instantes de expiração uniformemente distribuídos, quanto tempo em média um resolvedor continua servindo o valor anterior? E no pior caso? Qual fração ainda está desatualizada após dez minutos?
Solução: A espera média é $T/2 = 1800$ s, ou $30$ minutos, e o pior caso é $T = 3600$ s, ou $60$ minutos. A fração desatualizada em $t = 600$ s será dada por
\[f(600) = 1 - \frac{600}{3600} = 0{,}8\overline{3} = 83{,}33\%.\]Dez minutos depois de uma mudança urgente, cinco em cada seis resolvedores ainda respondem o valor anterior no modelo uniforme. Se a mudança desviava tráfego de um serviço quebrado, cinco sextos dos usuários atendidos por esses caches continuam sendo enviados para ele. Publicar outra resposta no autoritativo não invalida as cópias existentes. O mecanismo normal é a expiração.
| Cenário | Tempo ou fração desatualizada |
|---|---|
| Espera média | $1800$ s, ou $30$ min |
| Pior caso | $3600$ s, ou $60$ min |
| Após $600$ s | $83{,}33\%$ dos resolvedores |
Portanto, a média esconde uma cauda operacional em que alguns resolvedores conservam o valor anterior durante todo o TTL.
4. Planeje uma migração
O TTL atual é de $3600$ s e a mudança precisa propagar em até dois minutos. Descreva o procedimento e calcule os tempos.
Solução: O procedimento tem quatro etapas, e a primeira é a que se esquece.
| Etapa | Ação | Espera necessária | Por quê |
|---|---|---|---|
| 1 | reduzir o TTL para $60$ s | $3600$ s | todas as cópias com o TTL antigo precisam expirar |
| 2 | alterar o registro | nenhuma | agora a propagação é governada pelo TTL novo |
| 3 | aguardar a convergência | $60$ s | pior caso do TTL reduzido |
| 4 | restaurar o TTL para $3600$ s | nenhuma | restabelece a taxa de acerto e reduz a carga |
O tempo total é de $3660$ s, ou $61$ minutos, dos quais $3600$ são a espera da etapa 1. Quem pula essa espera e altera o registro logo após reduzir o TTL descobre que uma fração dos resolvedores guardou o valor anterior com o TTL anterior e continuará servindo-o por até uma hora. O defeito aparece somente para parte dos usuários, o que torna o diagnóstico penoso.
5. Calcule o custo da redução de TTL
Um domínio é consultado por um milhão de resolvedores distintos. Calcule a carga no autoritativo com TTL de $300$ s e de $30$ s. Para estimar o custo mensal, use a tabela do Route 53 consultada em 12 de setembro de 2026: US$ 0,40 por milhão no primeiro bilhão de consultas padrão e US$ 0,20 por milhão acima desse volume. Ignore o preço da zona hospedada.
Solução: A taxa agregada é $N/T$:
\[\frac{10^{6}}{300} = 3333{,}33\ \text{consultas/s}, \qquad \frac{10^{6}}{30} = 33\,333{,}33\ \text{consultas/s}.\]O volume mensal, com $2{,}592 \times 10^{6}$ segundos em trinta dias, será de $8{,}64 \times 10^{9}$ e $8{,}64 \times 10^{10}$ consultas. Como a tarifa muda depois do primeiro bilhão, precisamos separar os blocos:
\[C_{300} = 1000\times0{,}40 + 7640\times0{,}20 = \text{US\$ }1928,\] \[C_{30} = 1000\times0{,}40 + 85\,400\times0{,}20 = \text{US\$ }17\,480.\]| TTL | Consultas por segundo | Consultas em 30 dias | Custo estimado |
|---|---|---|---|
| $300$ s | $3333{,}33$ | $8{,}64$ bilhões | US$ $1928$ |
| $30$ s | $33\,333{,}33$ | $86{,}4$ bilhões | US$ $17\,480$ |
A carga cresce exatamente por um fator dez. A fatura cresce por $9{,}07$ porque o preço por milhão cai depois do primeiro bilhão. O preço precisa ser verificado na data da decisão. O que permanece é a direção do compromisso: um TTL menor aumenta a carga autoritativa e reduz a janela de inconsistência.
6. Calcule o tempo do cache negativo
Uma zona publica um SOA com TTL de $900$ s e campo MINIMUM igual a $300$ s. Um resolvedor recebe NXDOMAIN para api-nova.example.com às 10h00 e a equipe cria o nome às 10h01. Até que instante a ausência pode continuar sendo servida? O que mudaria se a resposta inicial fosse NODATA para o tipo AAAA?
Solução: O TTL negativo é o menor valor entre o TTL do SOA e seu campo MINIMUM:
A resposta recebida às 10h00 pode permanecer válida até 10h05. Criar o nome às 10h01 não invalida essa entrada, portanto o resolvedor ainda poderá devolver NXDOMAIN durante quatro minutos após a criação.
No caso de NODATA para AAAA, o nome já existia e somente aquele tipo estava ausente. Adicionar um AAAA às 10h01 também pode permanecer invisível até 10h05 para a combinação consultada. A diferença está no alcance da negação: NXDOMAIN nega o nome, enquanto NODATA nega o tipo naquele nome. Em ambos os casos, a correção autoritativa espera a expiração do cache negativo já distribuído.
4. Latência de resolução e o custo do primeiro acesso
A resolução acontece antes de qualquer conexão, e portanto antes de tudo que o Artigo 4 calculou. Ela é, literalmente, o primeiro item da fatura.
Uma resolução com os caches inicialmente vazios percorre o caminho da Figura 1. O resolvedor recursivo pergunta à raiz, obtém a delegação para o domínio de topo, consulta esse domínio, obtém a delegação para a zona e pergunta ao autoritativo pelo conjunto de registros. São três idas e voltas dentro da hierarquia. Com $30$ ms por salto, valor plausível para servidores bem distribuídos:
\[T_{\text{fria}} = 3 \times 30 = 90\ \text{ms},\]aos quais se soma a ida e volta do cliente até o resolvedor recursivo, tipicamente $3$ ms para o resolvedor do provedor de acesso, totalizando $93$ ms.
Uma consulta servida pelo cache do resolvedor custa apenas a ida e volta até ele: $3$ ms. Uma resposta do cache do próprio sistema operacional ou do navegador custa menos de $1$ ms no modelo.
O fator entre os dois extremos é de aproximadamente $93$. Ele ajuda a explicar por que a primeira visita a um nome ainda ausente dos caches pode parecer muito pior. Também explica por que a taxa de acerto da Seção 3 importa. Os $99{,}67\%$ de acerto evitam que essa fração de consultas pague, neste modelo, um custo até noventa vezes maior.
Três agravantes merecem número.
Domínios múltiplos. Uma página que carrega recursos de seis domínios distintos precisa de seis resoluções. Se todas começarem com os caches vazios e forem independentes, cada uma custa os $93$ ms do modelo. Sequencialmente, $6 \times 93 = 558$ ms. Em paralelo, o caminho crítico custa $93$ ms quando as seis têm a mesma duração. Navegadores sobrepõem consultas e podem antecipar nomes encontrados no documento precisamente por causa dessa conta.
Cadeias de CNAME. Cada novo nome pode exigir outra busca, mas não devemos multiplicar $90$ ms por elo sem declarar o estado do cache. A delegação e os endereços dos autoritativos consultados no primeiro elo podem servir aos seguintes. Como limite didático, suponha três buscas completas em espaços de nomes independentes, incluindo o endereço final. A hierarquia custa $3 \times 90 = 270$ ms e a ida e volta do cliente ao resolvedor é paga uma vez, totalizando $273$ ms. Na prática, precisamos medir quantas consultas externas a cadeia realmente provocou.
A escolha do resolvedor. Um resolvedor público distante, a $50$ ms, contra o resolvedor do provedor de acesso, a $3$ ms, acrescenta $47$ ms a cada consulta que precise alcançá-lo. Trocar de resolvedor por motivos de privacidade é uma decisão legítima e tem esse preço. O Artigo 15 voltará ao assunto ao tratar de identidade e confiança.
4.1 Exercícios da Seção 4
1. Decomponha o custo de uma resolução fria
Com $30$ ms por salto na hierarquia e $3$ ms até o resolvedor recursivo, calcule o tempo de uma resolução com caches vazios e compare com uma resposta do cache local em $1$ ms.
Solução: A hierarquia exige três consultas do resolvedor recursivo, à raiz, ao domínio de topo e ao autoritativo:
\[T_{\text{fria}} = 3 \times 30 + 3 = 93\ \text{ms}.\]A resposta do cache local custa $1$ ms, portanto o fator é $93$. Note que há uma medição intermediária. Com o cache do resolvedor preenchido e o cache do cliente vazio, o custo cai para os $3$ ms da ida e volta ao resolvedor, um fator de $31$ sobre a resolução completa com caches vazios.
| Resolução | Tempo | Fator sobre o cache local |
|---|---|---|
| Fria completa | $93$ ms | $93$ |
| Cache do resolvedor | $3$ ms | $3$ |
| Cache local | $1$ ms | $1$ |
A tabela mostra que cada nível de cache elimina uma parte distinta da hierarquia de consultas.
2. Calcule o custo de uma página com seis domínios
Uma página carrega recursos de seis domínios distintos, todos ausentes dos caches e independentes. Cada resolução custa $90$ ms dentro da hierarquia e $3$ ms entre cliente e resolvedor. Compare o custo sequencial e o paralelo.
Solução: Cada resolução completa custa
\[T_1 = 3\times30 + 3 = 93\ \text{ms}.\]Sequencialmente, as seis resoluções somam $6 \times 93 = 558$ ms. Em paralelo, todas partem juntas e o custo é o da mais lenta, ou $93$ ms sob a hipótese de tempos iguais.
A economia no caminho crítico é de $558-93=465$ ms. Registre, porém, a composição de caudas da Seção 6 do Artigo 1: se cada resolução tem probabilidade $p$ de exceder um limiar, a probabilidade de ao menos uma das seis exceder é $1 - (1-p)^{6}$. Para $p = 0{,}05$, isso dá $26{,}5\%$. O paralelismo reduz a soma para o máximo, mas o fan-out continua expondo a página à cauda da mais lenta.
| Estratégia | Tempo total | Economia |
|---|---|---|
| Sequencial | $558$ ms | $0$ ms |
| Paralela | $93$ ms | $465$ ms |
Portanto, o paralelismo reduz o caminho crítico por um fator seis sob tempos iguais, embora a página ainda herde a cauda da resolução mais lenta.
3. Quantifique o custo de uma cadeia de CNAME
Uma resolução exige três buscas frias completas em espaços de nomes independentes, incluindo a busca do A final. Use esse caso como limite superior para uma cadeia de CNAME, calcule o custo e proponha a correção.
Solução: Cada busca externa custa $90$ ms dentro da hierarquia. A consulta do cliente ao resolvedor envolve uma ida e volta de $3$ ms para a operação completa. Logo, o limite será
\[3 \times 90 + 3 = 273\ \text{ms},\]contra $93$ ms de um A direto no mesmo modelo, um acréscimo de $180$ ms. Na prática, elos sucessivos podem reutilizar delegações, endereços de autoritativos e até respostas incluídas na mesma mensagem. Por isso, $273$ ms é um limite construído pelas hipóteses, não uma tarifa fixa por três nomes.
A correção depende de onde a cadeia está. No ápice da zona, a saída pode ser o ALIAS admitido pelo provedor, que devolve um endereço direto. Fora do ápice, a saída é encurtar a cadeia, apontando diretamente para o alvo final quando o provedor intermediário não for necessário.
4. Compare dois resolvedores
Um resolvedor público está a $50$ ms e o do provedor de acesso a $3$ ms. Calcule o efeito sobre uma consulta servida pelo cache, sobre uma resolução com caches vazios e sobre uma página com seis domínios já armazenados.
Solução: Na consulta servida pelo cache, o custo é a ida e volta ao resolvedor: $50$ ms contra $3$ ms, uma diferença de $47$ ms. Com os caches vazios, ambos pagam os $90$ ms da hierarquia, e a diferença continua sendo os mesmos $47$ ms, agora sobre uma base maior: $140$ ms contra $93$ ms, ou $50{,}5\%$ a mais.
Para a página com seis domínios em cache, resolvidos em paralelo, a diferença permanece $47$ ms, porque o paralelismo faz o custo ser o do mais lento e todos estão à mesma distância. O resultado é contraintuitivo e vale registrar: a penalidade de um resolvedor distante aparece uma vez no caminho crítico, não uma vez por domínio, desde que as consultas sejam paralelas e tenham a mesma duração.
| Situação | Provedor a $3$ ms | Público a $50$ ms | Penalidade |
|---|---|---|---|
| Resolução quente | $3$ ms | $50$ ms | $47$ ms |
| Resolução fria | $93$ ms | $140$ ms | $47$ ms |
| Seis domínios quentes em paralelo | $3$ ms | $50$ ms | $47$ ms |
Assim, a distância acrescenta $47$ ms ao caminho crítico, não $47$ ms por domínio quando as consultas são paralelas.
5. Determine o efeito do cache do sistema operacional
O sistema operacional mantém um cache próprio e respeita o TTL recebido. Um serviço consulta o mesmo nome dez vezes por segundo, com TTL de $30$ s. Calcule as consultas que efetivamente saem da máquina.
Solução: Pela fórmula da Seção 3, com $\lambda = 10$ e $T = 30$, temos $\lambda T = 300$ e $h = 300/301 = 99{,}67\%$. Das $10$ consultas por segundo, saem da máquina
\[10 \times (1 - 0{,}9967) = 0{,}033\ \text{consulta/s},\]ou uma a cada $30$ segundos, que é exatamente uma por TTL. O cache local transforma dez consultas por segundo em uma consulta a cada meio minuto.
A consequência tem dois lados. De um lado, a rede é poupada. De outro, o processo fica preso ao valor antigo durante todo o TTL, e um serviço que caia será procurado no endereço errado por até 30 segundos, mesmo que o DNS já esteja publicando o endereço correto. É a mesma janela de inconsistência da Seção 3, agora dentro do processo, e é a razão de a Seção 6 somar o TTL ao tempo de detecção.
5. Políticas de roteamento como decisão de engenharia
Até aqui, um nome resolveu para um endereço. Provedores de nuvem transformaram o DNS em ponto de decisão: a resposta passa a depender de quem pergunta, de onde pergunta e do estado do sistema. É o roteamento por DNS, e ele é a forma mais barata de distribuição global de tráfego que existe, com limitações que precisam ser ditas.
Simples. Um conjunto de registros, todos devolvidos, e o cliente escolhe. Sem inteligência nenhuma. Serve como linha de base.
Roteamento ponderado. Cada registro recebe um peso, e o autoritativo escolhe respostas nessa proporção. A unidade da decisão é a consulta que chega ao autoritativo, não a requisição da aplicação. Com pesos $70/30$ e mil consultas autoritativas independentes, o número esperado de respostas para o primeiro alvo é $700$, com desvio padrão
\[\sigma = \sqrt{n p (1-p)} = \sqrt{1000 \times 0{,}7 \times 0{,}3} = 14{,}49,\]de modo que aproximadamente $95\%$ das amostras caem entre $671$ e $729$ pela aproximação normal. Medir $680$ respostas para o primeiro alvo é compatível com a política. Isso não permite afirmar que $68\%$ das requisições chegaram a ele, porque cada resposta pode ficar em cache e representar populações de tamanhos muito diferentes.
Pesos DNS não são percentuais de tráfego
O roteamento ponderado decide a proporção de respostas que o autoritativo devolve. A unidade da decisão é a consulta que chega ao servidor DNS, não a requisição da aplicação.
Entre a resposta e a requisição existem duas camadas de amplificação: o cache faz uma única resposta servir a milhares de requisições durante o TTL, e o tamanho das populações faz resolvedores diferentes representarem volumes de tráfego radicalmente diferentes.
O menor contraexemplo útil: quatro resolvedores, dois recebem resposta para A e dois para B. O DNS respeitou $50/50$. Se o resolvedor associado a A atende uma população muito maior, A pode receber $77\%$ das requisições ou $0{,}1\%$, dependendo de quem guardou o quê.
Se você precisa controlar a fração de requisições, o ponto de decisão precisa enxergar requisições. Balanceador de carga ou a própria aplicação. Pesos DNS servem para migração aproximada entre populações, desde que a exposição real seja medida nos destinos.
A Figura 3 mostra o menor contraexemplo útil. Quatro resolvedores recebem duas respostas para A e duas para B, exatamente $50/50$. Como um resolvedor associado a A atende uma população muito maior, o tráfego observado termina em $77{,}1/22{,}9$. O DNS respeitou os pesos das respostas e não controlou a fração de requisições.
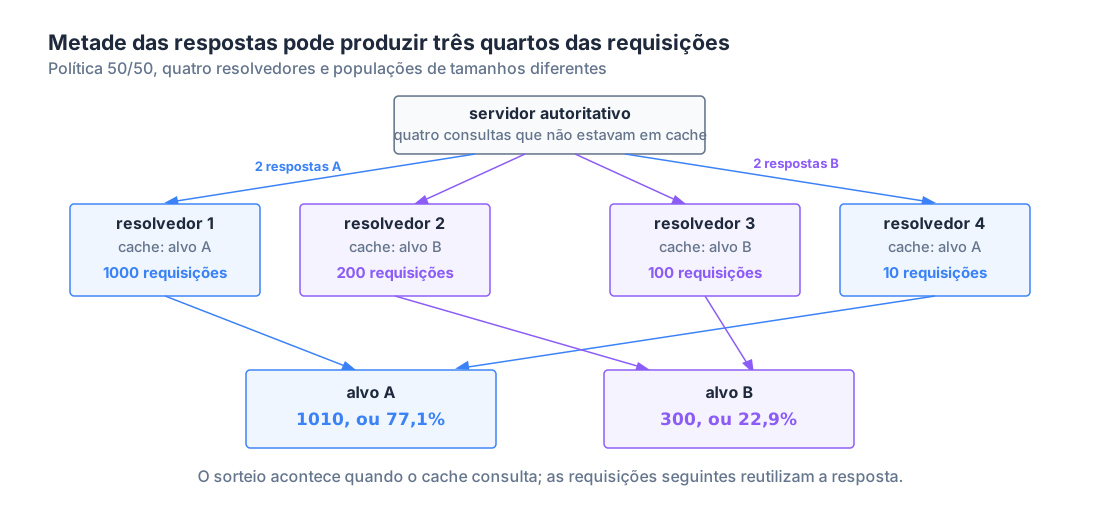 Figura 3: pesos governam respostas autoritativas. O cache e o tamanho desigual das populações transformam essas respostas em outra distribuição de requisições.
Roteamento por latência. O autoritativo estima qual região responde mais rápido para quem perguntou e devolve o endereço daquela região. Aqui está a limitação que precisa ser dita com todas as letras: o autoritativo não vê o cliente, vê o resolvedor recursivo. Um usuário em Manaus que utilize um resolvedor público cujo ponto de presença, ou PoP, esteja em São Paulo será tratado como se estivesse em São Paulo. A extensão de sub-rede do cliente, definida pela RFC 7871, permite ao resolvedor repassar um prefixo do endereço do usuário para reduzir esse erro. Porém, ela não é universal e tem custos de privacidade e de fragmentação do cache, pois a resposta passa a depender do prefixo e não apenas do nome.
Roteamento por geolocalização. Decide por país ou continente e atende a requisitos regulatórios ou de conteúdo, não a uma promessa de menor latência. Sofre da mesma limitação de enxergar o resolvedor.
Roteamento por contingência. Um registro é primário e outro é secundário, ambos associados a uma verificação de saúde. O secundário só é devolvido quando o primário é considerado indisponível. É o assunto da Seção 6.
Roteamento por resposta multivalorada. Vários registros saudáveis são devolvidos ao mesmo tempo, deixando o cliente escolher entre eles. A política combina verificações de saúde com a distribuição executada pelo cliente.
Uma observação sobre disponibilidade que vale para todas as políticas de contingência. Com dois destinos independentes de disponibilidade $a = 99{,}9\%$ cada, a disponibilidade combinada será dada por
\[A = 1 - (1-a)^{2} = 1 - 10^{-6} = 99{,}9999\%,\]o que reduz a indisponibilidade anual de $525{,}6$ para $0{,}53$ minuto. O número é lindo e a hipótese é otimista. Duas regiões do mesmo provedor compartilham o plano de controle, processos de implantação, versões de software e, frequentemente, a equipe de plantão. A correlação entre as falhas é positiva, e a disponibilidade real fica em algum ponto entre $99{,}9\%$ e $99{,}9999\%$ que essa fórmula não fornece. O Artigo 24, na trilha complementar, retomará o cálculo com o cuidado que ele merece.
5.1 Exercícios da Seção 5
1. Avalie uma política de roteamento ponderado
Uma política de roteamento ponderado $70/30$ recebe mil consultas autoritativas e o alvo primário aparece em $680$ respostas. A observação é compatível com a política?
Solução: Se as mil observações são consultas que chegaram ao autoritativo e cada escolha é independente, cada uma funciona como um ensaio de Bernoulli com $p = 0{,}7$. O número de respostas para o primário é binomial com média $np = 700$ e desvio padrão
\[\sigma = \sqrt{1000 \times 0{,}7 \times 0{,}3} = \sqrt{210} = 14{,}49.\]O valor observado está a $(700 - 680)/14{,}49 = 1{,}38$ desvio da média, dentro do intervalo aproximado de $95\%$, que vai de $671$ a $729$. A amostra é compatível com a política, mas não prova que a implementação está correta nem mede a fração de requisições.
Para verificar o efeito sobre tráfego, precisamos de duas contagens diferentes:
| Camada medida | Contagem necessária | O que ela permite concluir |
|---|---|---|
| autoritativo DNS | respostas A e B | aderência dos sorteios aos pesos |
| destinos da aplicação | requisições recebidas por A e B | exposição real de usuários e carga |
Confundir as duas camadas produz um canário que parece estar em $5\%$ na configuração e pode ficar muito acima ou abaixo disso na aplicação.
2. Dimensione uma implantação canário
Uma implantação canário usa um peso DNS de $5\%$. Cem resolvedores guardam as respostas. Cinco resolvedores corporativos representam $100\,000$ requisições diárias cada. Os outros noventa e cinco representam $100$ requisições cada. Suponha que exatamente cinco respostas apontem para o canário. Compare dois casos: no primeiro, uma resposta pertence a um resolvedor corporativo e quatro a resolvedores pequenos. No segundo, as cinco pertencem a resolvedores pequenos.
Solução: O tráfego diário total será
\[5\times100\,000 + 95\times100 = 509\,500\ \text{requisições}.\]No primeiro caso, o canário recebe um resolvedor corporativo e quatro pequenos:
\[\frac{100\,000 + 4\times100}{509\,500} = 19{,}71\%.\]No segundo, recebe apenas cinco populações pequenas:
\[\frac{5\times100}{509\,500} = 0{,}098\%.\]| Caso | Respostas DNS para o canário | Requisições no canário | Fração real |
|---|---|---|---|
| um resolvedor corporativo e quatro pequenos | $5\%$ | $100\,400$ | $19{,}71\%$ |
| cinco resolvedores pequenos | $5\%$ | $500$ | $0{,}098\%$ |
O mesmo peso nominal produz exposições que diferem por um fator superior a duzentos. Se precisamos controlar a porcentagem de requisições, o ponto de decisão deve enxergar requisições, como um balanceador de carga ou a própria aplicação. O roteamento DNS ponderado continua útil para uma migração aproximada entre populações, desde que a exposição real seja medida nos destinos.
3. Mostre a limitação do roteamento por latência
Um usuário em Manaus usa um resolvedor público cujo PoP mais próximo está em São Paulo. Que região a política de roteamento por latência escolherá e por quê?
Solução: O servidor autoritativo recebe a consulta do resolvedor, não do usuário, e a única informação de origem disponível é o endereço do resolvedor. Ele estima, portanto, a latência entre São Paulo e as regiões candidatas e devolve a região considerada melhor para São Paulo.
Se a melhor região para São Paulo for a Virgínia, o usuário de Manaus será enviado à Virgínia, mesmo que exista uma região mais próxima dele. O erro pode chegar a milhares de quilômetros e, pelos números do Artigo 1, a dezenas de milissegundos de RTT desnecessário.
A correção parcial é a extensão de sub-rede do cliente da RFC 7871, na qual o resolvedor repassa os primeiros bits do endereço do usuário. Ela custa privacidade, porque expõe a origem aproximada de cada consulta ao autoritativo. Também reduz a eficiência do cache, pois a resposta passa a variar por prefixo, diminui o $\lambda$ efetivo de cada entrada e, pela fórmula da Seção 3, diminui a taxa de acerto.
4. Calcule a disponibilidade de uma configuração com dois destinos
Dois destinos com disponibilidade individual de $99{,}9\%$, com falha independente. Calcule a disponibilidade combinada e a indisponibilidade anual.
Solução: O serviço só cai se ambos caírem:
\[A = 1 - (1 - 0{,}999)^{2} = 1 - 10^{-6} = 99{,}9999\%.\]A indisponibilidade anual passa de $0{,}001 \times 525\,600 = 525{,}6$ minutos para $10^{-6} \times 525\,600 = 0{,}53$ minuto.
A hipótese de independência é o ponto frágil. Se as falhas forem perfeitamente correlacionadas, a disponibilidade combinada continua $99{,}9\%$ e os $525{,}6$ minutos permanecem. O valor real depende da fração de causas comuns, e a única forma de reduzi-la é remover compartilhamento: provedores distintos, regiões distintas, processos de implantação decalados no tempo. Registre que redundância sem independência é decoração, e que a fórmula não informa se a independência existe: ela apenas supõe.
5. Determine quando o roteamento por contingência não protege
Um serviço usa roteamento por contingência entre duas regiões, ambas publicadas pelo mesmo provedor autoritativo de DNS. O que a política protege e o que ela não protege?
Solução: A política protege contra a falha de uma das duas regiões. A verificação de saúde detecta o problema, o autoritativo deixa de devolver o endereço da região indisponível e o tráfego migra no tempo que a Seção 6 calcula.
Ela não protege contra a falha do próprio serviço de DNS. Se o autoritativo ficar inalcançável, nenhuma resposta nova é produzida, e a política não tem como agir porque vive exatamente ali. Enquanto os TTLs em cache não expirarem, os clientes continuam funcionando com o valor armazenado. Depois disso, o nome deixa de resolver e duas regiões saudáveis ficam inalcançáveis por um problema que não pertence a nenhuma delas.
A defesa é delegar a zona a conjuntos de servidores de provedores distintos, com os registros NS do ápice apontando para ambos, de modo que a indisponibilidade de um provedor não impeça a resolução. É exatamente a dependência que o incidente da Seção 7 torna visível.
6. Verificação de saúde e o tempo real de recuperação
Esta é a seção que muda decisões, e ela existe porque o tempo de recuperação de um serviço com DNS quase nunca é o que a equipe imagina.
O mecanismo tem três parâmetros: o intervalo, período entre sondagens; o limiar, número de falhas consecutivas necessárias para declarar o alvo indisponível; e o TTL do registro devolvido pela política. Se a falha ocorre logo depois de uma sondagem bem-sucedida e um resolvedor acabou de guardar a resposta anterior, um limite superior didático será
\[T_{\text{rec}} = \text{intervalo} \times \text{limiar} + \text{TTL}.\]A primeira parcela limita a detecção nesse cenário, enquanto a segunda limita a propagação para um cache que respeita o TTL. O valor real depende da fase da sondagem e da idade de cada entrada. A Tabela 5 mantém o pior caso construído para mostrar o peso de cada parâmetro.
| Intervalo | Limiar | TTL | Detecção | Total |
|---|---|---|---|---|
| $30$ s | 3 | $60$ s | $90$ s | $150$ s |
| $30$ s | 3 | $300$ s | $90$ s | $390$ s |
| $10$ s | 3 | $60$ s | $30$ s | $90$ s |
| $10$ s | 2 | $20$ s | $20$ s | $40$ s |
| $5$ s | 2 | $30$ s | $10$ s | $40$ s |
Tabela 5: tempo até o tráfego migrar, no pior caso. Entre a primeira e a segunda linha, apenas o TTL mudou, e o tempo de recuperação subiu 160%.
Compare as duas primeiras linhas. A detecção é idêntica, de $90$ segundos, e o total salta de $150$ para $390$ segundos porque o TTL passou de $60$ para $300$. Na segunda configuração, o TTL responde por $77\%$ do limite. Uma equipe que ajuste intervalo e limiar sem examinar esse valor pode reduzir a detecção à metade e ainda preservar a maior parcela do tempo de recuperação.
Os três parâmetros que decidem o tempo de recuperação
Intervalo é o tempo entre sondagens. Reduzi-lo acelera a detecção, mas multiplica o tráfego de verificação e aumenta a chance de falso positivo por erro transitório.
Limiar é quantas falhas consecutivas declaram o alvo indisponível. Aumentá-lo reduz falsos positivos, mas acrescenta tempo à detecção.
TTL é o valor que cada resolvedor guarda antes de perguntar de novo. Reduzi-lo acelera a propagação, mas multiplica a carga no autoritativo. Pela Tabela 3, cada redução por dez multiplica as consultas por dez.
Nas duas primeiras linhas da Tabela 5, detecção e limiar são idênticos e o total salta de 150 para 390 segundos por causa do TTL. Antes de ajustar sondagens, verifique quanto do tempo de recuperação pertence ao TTL. Em muitos sistemas, é a maior parcela.
A Figura 4 empilha as duas parcelas para as cinco configurações da Tabela 5.
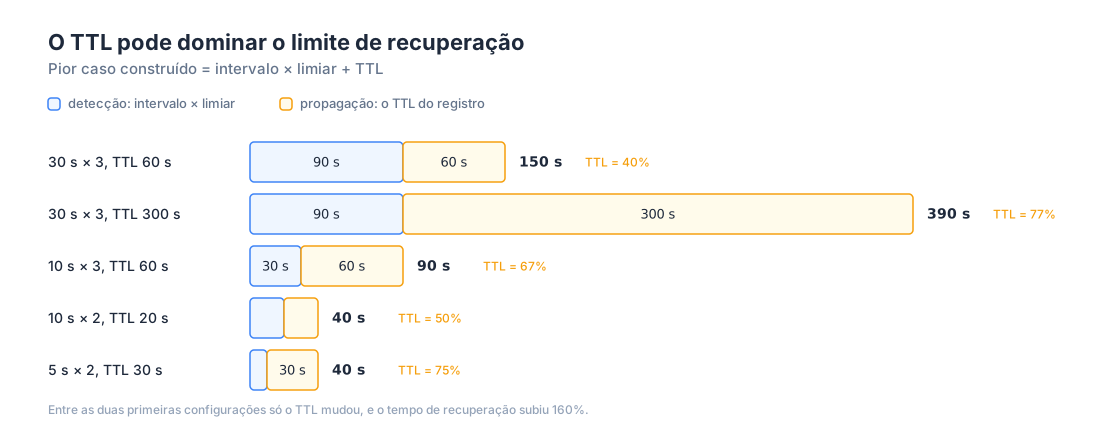 Figura 4: no pior caso construído, a detecção e o TTL somam-se. Nas duas primeiras configurações, apenas o TTL mudou, e ele responde por 40% e por 77% do limite.
Há três razões para não levar todos os parâmetros ao mínimo, e as três precisam ser quantificadas.
Custo no autoritativo. Reduzir o TTL multiplica as consultas, pela Tabela 3. O TTL de $20$ segundos da quarta linha custa quinze vezes mais consultas que o de $300$.
Custo da sondagem. Sondar de cinco em cinco segundos a partir de várias localidades produz um volume de requisições que o próprio serviço precisa atender, e que aparece nos registros de acesso como tráfego que não é de usuário.
Falso positivo. Com limiar $2$, intervalo de $10$ s e probabilidade independente de erro transitório de $1\%$ por sondagem, qualquer par consecutivo falha com probabilidade $10^{-4}$. Tratar os $8640$ instantes do dia como oportunidades produz aproximadamente $0{,}86$ sequência por dia, ou uma a cada $28$ horas. É uma aproximação, porque pares vizinhos se sobrepõem e erros reais podem ser correlacionados. O limiar troca tempo de detecção por robustez, e o valor certo depende da taxa e da correlação observadas.
Falta distinguir duas situações que costumam ser somadas indevidamente. Quando cada camada respeita o TTL remanescente devolvido pela camada anterior, três caches não criam três TTLs completos. Todos permanecem dentro da janela iniciada no cache mais antigo. O tempo pode exceder o TTL autoritativo quando uma camada impõe sua própria política, por exemplo ao fixar sessenta segundos mesmo que tenha recebido um segundo remanescente. Nesse caso, o excesso pertence à política local e precisa ser medido como tal.
6.1 Exercícios da Seção 6
1. Calcule o tempo de recuperação de duas configurações
Com intervalo de $30$ s e limiar $3$, calcule o tempo de recuperação para TTL de $60$ s e de $300$ s.
Solução: A detecção é $30 \times 3 = 90$ s nas duas. Somando o TTL:
\[T_{60} = 90 + 60 = 150\ \text{s}, \qquad T_{300} = 90 + 300 = 390\ \text{s}.\]A diferença é de $240$ s, ou quatro minutos, e vem inteiramente de um parâmetro que não pertence à verificação de saúde. No primeiro caso, o TTL responde por $40\%$ do total. No segundo, por $76{,}9\%$. Antes de investir em sondagens mais frequentes, vale conferir qual das duas parcelas domina.
2. Projete uma configuração para um alvo de 60 segundos
Determine uma configuração cujo tempo de recuperação fique abaixo de $60$ s e calcule o custo em consultas ao autoritativo com um milhão de resolvedores.
Solução: É preciso que $\text{intervalo} \times \text{limiar} + \text{TTL} < 60$. Com intervalo de $10$ s e limiar $2$, a detecção é $20$ s e sobram $40$ s para o TTL. Adotando $30$ s, o total será dado por
\[T_{\text{rec}} = 20 + 30 = 50\ \text{s}.\]O custo, pela Tabela 3, é $10^{6}/30 = 33\,333{,}33$ consultas por segundo, contra $3333{,}33$ com TTL de $300$ s. São dez vezes mais consultas para reduzir o limite de recuperação de $390$ para $50$ segundos.
A decisão é econômica e não técnica: vale saber quanto custa um minuto de indisponibilidade para o negócio e comparar com a diferença de fatura. Uma conta é substituída pela outra, o que já é melhor que substituí-la por intuição.
3. Calcule a taxa de falso positivo
Com intervalo de $10$ s, limiar $2$ e probabilidade de erro transitório de $1\%$ por sondagem, calcule a frequência esperada de remoções indevidas.
Solução: Duas falhas consecutivas independentes têm probabilidade
\[p = 0{,}01^{2} = 10^{-4}\]por ciclo de avaliação. Com $86\,400/10 = 8640$ ciclos por dia, o número esperado será dado por
\[8640 \times 10^{-4} = 0{,}864\ \text{remoção indevida por dia},\]ou uma a cada $27{,}8$ horas. Elevar o limiar para $3$ reduz para $8640 \times 10^{-6} = 0{,}0086$ por dia, ou uma a cada $116$ dias, ao custo de $10$ s a mais de detecção. A frequência cai por um fator cem, isto é, duas ordens de grandeza, sob a hipótese de independência.
4. Separe TTL remanescente de política local
Use a configuração do exercício 1, com detecção de $90$ s e TTL autoritativo de $60$ s. Compare dois clientes. O primeiro respeita o TTL remanescente em todas as camadas. O segundo usa um navegador que fixa sua entrada por $60$ s, mesmo quando recebe apenas $1$ s de TTL remanescente no instante $59$ após a mudança do registro.
Solução: No cliente compatível, o resolvedor recursivo pode conservar a resposta anterior por até $60$ s depois da mudança. Se o sistema operacional consulta quando restam $10$ s, recebe esse valor remanescente. Se o navegador consulta um pouco depois, recebe um valor ainda menor. As camadas não reiniciam o relógio. O limite permanece
\[90 + 60 = 150\ \text{s}.\]No segundo cliente, o navegador consulta no instante $59$ e recebe uma resposta antiga com $1$ s remanescente. Ao substituí-lo por uma retenção local fixa de $60$ s, ele pode servir o endereço antigo até o instante $119$ depois da mudança. O limite percebido passa a
\[90 + 119 = 209\ \text{s}.\]| Cliente | Regra das camadas | Limite após a detecção |
|---|---|---|
| compatível | preserva o TTL remanescente | $60$ s |
| navegador com retenção fixa | transforma $1$ s remanescente em $60$ s | $119$ s |
O valor adicional não vem da existência de três caches. Vem de uma camada que estende deliberadamente o TTL recebido. Para diagnosticar esse caso, precisamos registrar o TTL devolvido em cada consulta e a política efetiva do cliente.
5. Explique por que uma verificação de saúde pode enganar
Uma verificação de saúde consulta a rota /health de um serviço, que devolve $200$ sempre que o processo está em execução. Que classe de falha ela não detecta?
Solução: Ela detecta o processo morto, o porto fechado e a máquina inalcançável. Não detecta nenhuma falha em que o processo está vivo e o serviço está quebrado: banco de dados inacessível, dependência externa fora do ar, disco cheio, coletor de lixo em pausa prolongada, ou a versão nova respondendo $200$ com conteúdo errado.
Nesses casos a verificação continua verde, o destino permanece no conjunto e o tempo de recuperação é infinito, porque a migração nunca é acionada. A correção é fazer a rota de saúde exercitar as dependências críticas e devolver falha quando alguma delas estiver indisponível, aceitando o risco oposto: uma dependência lenta passa a derrubar destinos saudáveis, e a falha se propaga em vez de ficar contida.
Não há escolha universalmente certa entre as duas, e é por isso que a prática comum separa duas rotas, uma de vivacidade, que só diz se o processo respira, e outra de prontidão, que diz se ele consegue atender. O Artigo 14 volta a essa distinção com os nomes que o Kubernetes lhes dá.
7. O DNS como superfície de ataque e de falha
As especificações originais do DNS não ofereciam autenticação criptográfica nem confidencialidade por padrão. A rede mudou, mas as três consequências centrais dessa decisão continuam conosco: reflexão de tráfego, respostas forjadas e exposição dos nomes consultados.
Reflexão e amplificação. Uma consulta UDP pequena pode produzir uma resposta grande, e o UDP não confirma a origem antes de responder. Um atacante envia consultas com o endereço de origem da vítima. Os servidores usados como refletores devolvem as respostas para esse endereço, de modo que a vítima recebe tráfego que nunca pediu. Em um exemplo com uma consulta de $64$ bytes e uma resposta de $3000$ bytes, o fator de tamanho será dado por
\[a = \frac{3000}{64} = 46{,}875 \approx 46{,}9.\]Cada bit enviado pelo atacante pode provocar até $46{,}9$ bits de resposta dentro dessa fronteira de contagem. O valor não inclui cabeçalhos de IP e UDP e não garante que os refletores entreguem toda a capacidade disponível. Ainda assim, ele mostra por que a falsificação do endereço de origem transforma assimetria de tamanho em arma. As defesas combinam limitação da taxa de respostas, recusa de recursão para clientes não autorizados e filtragem de pacotes com origem forjada na saída, prática que o Artigo 6 retomará.
Respostas grandes também encontram um limite de transporte. Implementações DNS de propósito geral precisam suportar UDP e TCP segundo a RFC 7766. Quando uma resposta UDP não cabe no tamanho admitido, o servidor marca o bit TC de truncamento e o resolvedor repete a consulta por outro transporte, normalmente TCP. A RFC 9715 recomenda $1400$ bytes como limite máximo padrão da carga DNS sobre UDP e permite valores menores. O valor $1232$, adotado por várias implementações, é uma escolha conservadora derivada da MTU mínima do IPv6 menos os cabeçalhos IPv6 e UDP. A lição não é decorar um único número. É não presumir que uma resposta DNS grande continuará sendo um único datagrama.
Envenenamento do cache. Um resolvedor que aceite uma resposta forjada guarda o valor errado durante o TTL e o serve a todos os seus clientes. O DNSSEC enfrenta esse problema fornecendo autenticação de origem e integridade para conjuntos de registros. Ele não cifra consultas e não impede ataques de negação de serviço.
A validação começa em uma âncora de confiança conhecida pelo resolvedor. A chave DNSKEY da zona pai verifica a assinatura do registro DS da filha. O resumo contido no DS identifica uma DNSKEY da filha. Essa chave, por fim, verifica a assinatura RRSIG que cobre o conjunto de registros pedido. A Figura 5 torna visível a alternância entre verificar uma assinatura e comparar o resumo de uma chave.
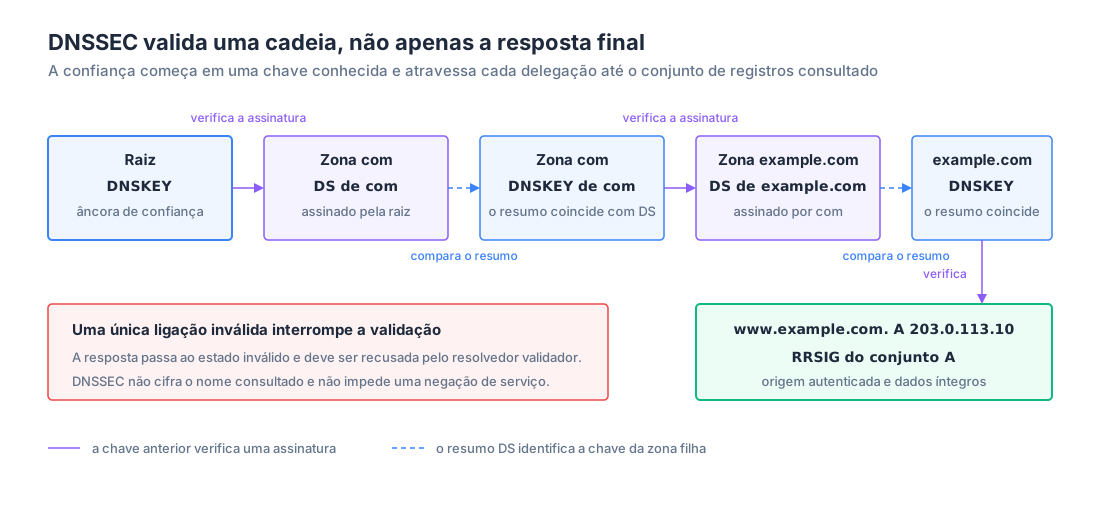 Figura 5: a confiança atravessa cada delegação. Uma única assinatura inválida ou um resumo que não coincida torna a resposta inválida para um resolvedor validador.
Esse encadeamento explica por que uma falha operacional pode parecer uma defesa bem-sucedida. Se a assinatura expira ou o registrador publica um DS que não corresponde mais à chave da zona, o resolvedor validador recusa a resposta. Para ele, entregar um endereço não autenticado como se fosse seguro seria exatamente a falha que DNSSEC existe para impedir. Zero validação deixa a falsificação sem defesa. Uma cadeia assinada e mal operada torna o nome indisponível. A segurança exige chaves corretas e rotação coordenada, não apenas a presença de registros criptográficos.
Privacidade. Consultas em texto claro expõem a intermediários os nomes que a leitora acessa. DNS sobre TLS, ou DoT, e DNS sobre HTTPS, ou DoH, cifram o trecho entre o cliente e o resolvedor configurado. Eles não cifram automaticamente o trecho entre esse resolvedor e os servidores autoritativos. Portanto, a observação muda de lugar: o provedor de acesso perde parte da visibilidade, enquanto o operador do resolvedor passa a concentrá-la. Cifrar o canal é valioso, mas não elimina a decisão sobre em quem confiar.
Vale examinar dois incidentes, porque ambos devolvem as abstrações anteriores ao mundo operacional.
Dyn, outubro de 2016. Um ataque distribuído de negação de serviço, originado em uma rede de dispositivos comprometidos, atingiu a infraestrutura autoritativa da Dyn em ondas ao longo de um dia. Serviços que dependiam daquele provedor ficaram inalcançáveis, embora seus próprios servidores estivessem intactos. O incidente torna concreta a pergunta do exercício 5 da Seção 5: o plano de redundância inclui o serviço autoritativo ou termina antes dele?
Facebook, outubro de 2021. Uma alteração de configuração retirou os anúncios de rota dos prefixos que continham os servidores autoritativos da empresa. Os servidores estavam funcionando, mas deixaram de ser alcançáveis. À medida que os caches expiravam, os nomes deixavam de resolver e os serviços desapareciam da Internet. A falha original era de roteamento, tema do próximo artigo, mas se manifestou como falha de nomes porque a dependência entre as duas camadas é assimétrica e silenciosa.
Os dois casos compartilham uma ironia operacional. Durante o intervalo em que as respostas armazenadas ainda eram válidas, parte dos usuários continuou funcionando. O cache que prolonga uma resposta errada é o mesmo que adia uma indisponibilidade autoritativa. É o compromisso da Seção 3 aparecendo em um dia ruim.
A mesma propriedade que ajuda é a que atrapalha
Durante uma falha autoritativa, o cache continua servindo respostas por algum tempo, e isso é bom: os usuários seguem funcionando enquanto a equipe corrige o problema.
Durante uma migração, o mesmo cache retém valores antigos por mais tempo que a equipe gostaria, e isso é ruim: parte dos usuários continua no destino anterior mesmo depois de a mudança estar publicada.
Não há como ter uma sem a outra. O TTL é o único parâmetro que governa as duas pontas, e a decisão de aumentá-lo ou reduzi-lo precisa levar em conta qual dos dois lados pesa mais para o serviço. Um serviço com falhas frequentes e curtas prefere TTL longo. Um serviço que precisa migrar rápido prefere TTL curto e aceita pagar a carga no autoritativo.
7.1 Exercícios da Seção 7
1. Calcule o fator de amplificação
Um atacante envia consultas UDP de $64$ bytes que provocam respostas de $3000$ bytes. Calcule o fator de amplificação da carga útil e o tráfego recebido pela vítima quando o atacante distribui $2$ Gbit/s de consultas entre refletores. Ignore os cabeçalhos.
Solução: O fator será a razão entre resposta e consulta:
\[a = \frac{3000}{64} = 46{,}875.\]Multiplicamos a taxa enviada pelo fator:
\[R_{\text{vítima}} = 2 \times 46{,}875 = 93{,}75\ \text{Gbit/s}.\]O cálculo estabelece um limite dentro da fronteira fornecida. Perdas, limitação de taxa e capacidade dos refletores podem reduzir o valor real. Porém, a vítima continua recebendo muito mais tráfego do que o atacante precisou originar, pois o UDP permitiu refletir as respostas para um endereço falsificado.
2. Determine quando o DNS troca de transporte
Um resolvedor anuncia que aceita $1232$ bytes de carga DNS sobre UDP. O servidor precisa devolver $1800$ bytes. Explique o comportamento correto e por que fragmentar a resposta não é a primeira escolha operacional.
Solução: A resposta excede o limite anunciado em
\[1800 - 1232 = 568\ \text{bytes}.\]O servidor pode devolver uma resposta truncada com TC=1. O resolvedor então repete a consulta por um transporte capaz de carregar a mensagem completa, normalmente TCP. Fragmentar no IP faria a entrega depender de todos os fragmentos e de intermediários que nem sempre os encaminham ou remontam corretamente. A troca de transporte preserva a mensagem completa sem transformar fragmentação em requisito de funcionamento.
3. Rastreie a cadeia de confiança
Um resolvedor confia na DNSKEY da raiz. Ele verifica o DS de com, encontra uma DNSKEY de com cujo resumo coincide, verifica o DS de example.com, mas o resumo desse DS não coincide com nenhuma DNSKEY da zona. Qual deve ser o resultado da validação?
Solução: As duas primeiras ligações são válidas, mas elas não autorizam pular a terceira. O DS publicado pelo pai afirma qual chave da filha continua a cadeia. Se nenhuma DNSKEY de example.com produz o resumo esperado, a autenticação é interrompida antes de chegar ao conjunto A.
| Ligação | Resultado | Consequência |
|---|---|---|
âncora da raiz verifica DS de com |
válida | podemos avaliar a chave de com |
resumo do DS coincide com DNSKEY de com |
válido | podemos avaliar a delegação seguinte |
resumo do DS de example.com coincide com uma DNSKEY filha |
inválido | a cadeia termina sem autenticar os dados finais |
O resolvedor validador deve classificar a resposta como inválida e recusá-la segundo sua política. Aceitar o A final apesar da divergência converteria a cadeia de confiança em decoração.
4. Separe integridade de confidencialidade
Uma equipe habilita DNSSEC e conclui que o provedor de acesso já não consegue observar os nomes consultados. Avalie a conclusão e proponha o mecanismo correspondente à propriedade desejada.
Solução: A conclusão é falsa. DNSSEC autentica a origem dos dados e detecta alteração nos conjuntos assinados. Ele não cifra o nome da consulta nem a resposta.
Para ocultar esse trecho do provedor de acesso, o cliente pode usar DoT ou DoH até um resolvedor escolhido. O nome fica cifrado nesse canal, mas o operador do resolvedor ainda conhece a consulta e pode precisar enviá-la aos autoritativos por outro canal. A propriedade obtida é confidencialidade do transporte em um trecho definido, não anonimato fim a fim.
5. Explique por que o cache ajuda durante uma falha autoritativa
Um provedor autoritativo fica inalcançável às 14h00. Um resolvedor guardou às 13h58 um registro com TTL de $300$ s. Até quando ele pode continuar respondendo, e o que acontece depois?
Solução: O registro permanece válido durante cinco minutos após 13h58:
\[13\text{h}58 + 300\ \text{s} = 14\text{h}03.\]Até 14h03, o resolvedor pode atender seus clientes sem consultar o autoritativo. Depois da expiração, precisa atualizar a resposta. Se os servidores continuarem inalcançáveis e nenhuma política explícita autorizar dados vencidos, a resolução falha.
O TTL comprou três minutos de continuidade depois do início da falha, pois dois dos cinco minutos já haviam sido consumidos. O mesmo mecanismo que atrasa uma migração também absorve uma indisponibilidade curta do plano autoritativo. A idade da entrada no instante da falha decide qual lado do compromisso aparece.
8. Anycast e a raiz distribuída
Há uma pergunta que a Seção 1 deixou pendente. Se existem apenas treze identificadores de servidores raiz, e a Internet inteira depende deles, como isso não é um gargalo absurdo?
A resposta é o anycast. Um mesmo endereço é anunciado, por roteamento, a partir de dezenas ou centenas de locais físicos. O roteamento entrega o pacote segundo a topologia, e nem o cliente nem o servidor precisam saber que existem outros locais. Em 12 de setembro de 2026, os treze identificadores correspondiam a $2045$ instâncias operacionais espalhadas pelo planeta.
O ganho de latência é direto. Suponha usuários distribuídos como na tabela abaixo, com a latência até um servidor único em São Paulo e até a instância anycast mais próxima de cada um:
| Região do usuário | Fração | Até o nó único | Até a instância mais próxima |
|---|---|---|---|
| A | $40\%$ | $95$ ms | $8$ ms |
| B | $25\%$ | $95$ ms | $95$ ms |
| C | $20\%$ | $95$ ms | $120$ ms |
| D | $10\%$ | $95$ ms | $180$ ms |
| E | $5\%$ | $95$ ms | $210$ ms |
A latência média com o nó único é $95$ ms. Com anycast, é a média ponderada da última coluna:
\[0{,}40 \times 8 + 0{,}25 \times 95 + 0{,}20 \times 120 + 0{,}10 \times 180 + 0{,}05 \times 210 = 79{,}45\ \text{ms},\]uma redução de $16{,}4\%$. Repare que algumas regiões pioraram: a coluna da direita é maior que a do meio nas linhas C, D e E, porque a instância topologicamente mais próxima nem sempre é a geograficamente mais próxima. Anycast otimiza a média e não garante o percentil de ninguém, o que é uma propriedade importante e raramente mencionada.
Há ainda dois pontos que a leitora precisa levar.
Anycast e UDP combinam, mas anycast e TCP exigem cuidado. Cada consulta UDP é independente. Se duas consultas consecutivas forem para instâncias diferentes, nenhuma carrega estado de transporte da anterior. Uma conexão TCP, contudo, tem estado em uma instância. Se a rota mudar no meio da conexão, os pacotes podem chegar a outra instância, que não conhece números de sequência nem janelas daquele fluxo. Como o DNS usa TCP para respostas grandes e transferências de zona, operadores anycast precisam proteger a estabilidade das rotas durante a vida das conexões.
Anycast pode reagir sem esperar o TTL. Se uma instância cai e o anúncio do prefixo é retirado, o roteamento procura outro caminho. O tempo depende da detecção, da retirada e da convergência, portanto pode ir de segundos a minutos. A propriedade importante é outra: o endereço não muda e nenhum cache DNS precisa expirar. As duas técnicas podem trabalhar juntas, com anycast reagindo dentro de um serviço e DNS decidindo entre serviços.
8.1 Exercícios da Seção 8
1. Calcule o ganho de latência do anycast
Com a distribuição de usuários da tabela desta seção, calcule a latência média com o nó único e com anycast.
Solução: Com nó único, todos pagam $95$ ms, e a média é $95$ ms. Com anycast, a média ponderada será dada por
\[0{,}40(8) + 0{,}25(95) + 0{,}20(120) + 0{,}10(180) + 0{,}05(210) = 3{,}2 + 23{,}75 + 24 + 18 + 10{,}5 = 79{,}45\ \text{ms}.\]A redução é de $15{,}55$ ms, ou $16{,}4\%$. Note que o ganho vem quase inteiramente da região A, responsável por $40\%$ dos usuários e por uma queda de $87$ ms, enquanto as regiões C, D e E pioraram. Anycast é uma otimização de média cujo benefício se concentra onde há instâncias, e é por isso que a distribuição geográfica dos usuários precisa entrar na decisão de onde instalar pontos de presença.
2. Explique por que uma sessão TCP pode quebrar sobre anycast
Uma transferência de zona por TCP atravessa uma mudança de rota. Descreva o que acontece.
Solução: A conexão foi estabelecida com uma instância específica, que mantém números de sequência, janelas e o estado da transferência. A mudança de rota faz os pacotes seguintes chegarem a outra instância, que anuncia o mesmo endereço e não tem estado nenhum daquela conexão. Ela responde com um segmento de reinicialização, e a conexão morre.
O cliente precisa reabrir e recomeçar. Para uma consulta UDP isolada, a troca de instância pode ser invisível. Para uma transferência de zona de vários megabytes, significa perder o progresso. Daí a exigência de estabilidade de rota nos serviços anycast que usam TCP.
3. Compare os tempos de reação de anycast e de DNS
Uma instância cai. Suponha que a retirada do anúncio e a convergência anycast levem $15$ s. Compare esse valor com as configurações DNS de $150$ s e $390$ s da Tabela 4.
Solução: Pela hipótese do enunciado, o caminho anycast migra em $15$ s. A decisão acontece no roteamento e o endereço não muda, portanto não acrescentamos TTL DNS.
Pelo DNS, os dois casos pedidos custam $150$ s e $390$ s no pior caso construído da Seção 6.
As razões são $150/15=10$ e $390/15=26$. Neste exemplo, anycast reage entre dez e vinte e seis vezes mais depressa. A conclusão depende dos $15$ s fornecidos, pois não existe tempo universal de convergência anycast.
| Mecanismo | Tempo de reação | Limite dominante |
|---|---|---|
| Anycast, hipótese do exercício | $15$ s | retirada e convergência de roteamento |
| DNS, duas configurações | $150$ s e $390$ s | detecção e TTL |
Portanto, o anycast reage mais depressa sob os parâmetros do exercício, enquanto o DNS oferece uma política mais fina entre serviços.
4. Determine o efeito da dispersão sobre um ataque volumétrico
Um ataque de $600$ Gbit/s é dirigido a um endereço anycast anunciado de $200$ locais. Estime o volume por local e comente.
Solução: O tráfego de ataque também é roteado ao local topologicamente mais próximo de cada origem. Se as origens estiverem uniformemente distribuídas, cada local recebe em média
\[\frac{600}{200} = 3\ \text{Gbit/s},\]mas essa média não diz se algum local sobrevive. Um ponto com capacidade de $2$ Gbit/s já estaria saturado. Um ponto com $10$ Gbit/s teria margem. Anycast dispersa origens segundo a topologia, mas não cria capacidade e não garante divisão uniforme.
A hipótese de uniformidade é o ponto a vigiar. Redes de dispositivos comprometidos são concentradas geograficamente, e o local mais próximo da concentração pode receber uma fração muito maior que $1/200$. A defesa dimensiona-se pela concentração observada e não pela média, aplicando o mesmo raciocínio de percentil contra média da Seção 6 do Artigo 1.
5. Determine quando anycast não resolve
Um serviço mantém estado por usuário na instância que o atende. Anycast serve?
Solução: Anycast, sozinho, não resolve. Requisições sucessivas do mesmo usuário podem chegar a instâncias diferentes conforme a rota mude, e cada instância só conhece o estado que ela própria criou. O usuário observa um serviço que esquece o que acabou de fazer.
As saídas são três, e todas custam: manter o estado em um repositório compartilhado, pagando a latência de acesso a ele em cada requisição; usar afinidade de sessão, o que exige que a camada de decisão veja o usuário e não apenas a rota; ou tornar o serviço sem estado, transportando a informação necessária no próprio pedido. A Seção 4 do Artigo 15 retomará a última alternativa ao tratar de decisões locais com dados assinados.
9. O núcleo de um resolvedor em C++23
O formato de mensagem do DNS é pequeno e tem uma particularidade que vale implementar à mão: a compressão de nomes. Como o mesmo sufixo aparece muitas vezes em uma resposta, a RFC 1035 permite substituir um sufixo por um ponteiro de catorze bits para outro ponto da mesma mensagem. É engenhoso, economiza espaço real, e abre uma porta de segurança que precisa ser fechada explicitamente.
Um rótulo cujos dois bits mais significativos são 11 é um ponteiro. Se são 00, é um rótulo comum, com o comprimento nos seis bits restantes. Nada no formato impede que um ponteiro aponte para si mesmo, ou que dois ponteiros apontem um para o outro. Um analisador ingênuo entra em laço infinito, e uma mensagem de dezoito bytes derruba o processo. É a bomba de descompressão, e a defesa é um limite de saltos.
O programa abaixo constrói uma consulta, analisa uma resposta sintética completa com dois níveis de compressão e recusa uma mensagem com ponteiro circular. Ele não envia datagramas e, portanto, não é um resolvedor completo. Implementa o núcleo de codificação e análise que um resolvedor precisaria proteger. O código usa std::expected para tornar as falhas parte do contrato, std::span para observar uma sequência contígua sem copiá-la e std::print com std::format para produzir a saída.
// dns.cpp: construção de consulta e análise de resposta DNS, com compressão de nomes.
// MSVC 19.51: cl /std:c++latest /utf-8 /W4 /WX /EHsc /O2 dns.cpp
// Clang: clang++ -std=c++23 -stdlib=libc++ -O2 -Wall -Wextra dns.cpp -o dns

#include <cstddef>
#include <cstdint>
#include <expected>
#include <format>
#include <print>
#include <span>
#include <string>
#include <string_view>
#include <utility>
#include <vector>

namespace dns {

enum class Erro {
    mensagem_curta,     // faltam bytes para o campo pedido
    rotulo_invalido,    // os dois bits altos não são 00 nem 11
    rotulo_longo,       // um rótulo DNS passa de 63 bytes
    ponteiro_fora,      // o ponteiro aponta para fora da mensagem
    laco_de_ponteiros,  // a cadeia excede o orçamento de saltos
    nome_longo,         // o nome montado passa de 255 bytes
    rdata_invalida      // o valor de um registro invade o campo seguinte
};

constexpr std::string_view descrever(Erro e) {
    switch (e) {
        case Erro::mensagem_curta:    return "mensagem curta";
        case Erro::rotulo_invalido:   return "rotulo invalido";
        case Erro::rotulo_longo:      return "rotulo longo demais";
        case Erro::ponteiro_fora:     return "ponteiro fora da mensagem";
        case Erro::laco_de_ponteiros: return "laco de ponteiros";
        case Erro::nome_longo:        return "nome longo demais";
        case Erro::rdata_invalida:    return "rdata invalida";
    }
    return "erro desconhecido";
}

// ---------- construção ----------

// Cada rótulo recebe um byte de comprimento, e o zero final representa a raiz.
std::expected<std::vector<std::byte>, Erro> codificar_nome(std::string_view nome) {
    if (nome == ".") return std::vector<std::byte>{std::byte{0}};
    if (nome.ends_with('.')) nome.remove_suffix(1);
    if (nome.empty()) return std::unexpected(Erro::rotulo_invalido);

    std::vector<std::byte> saida;
    saida.reserve(nome.size() + 2);
    std::size_t inicio = 0;
    while (inicio < nome.size()) {
        const auto ponto = nome.find('.', inicio);
        const auto fim = (ponto == std::string_view::npos) ? nome.size() : ponto;
        const auto tam = fim - inicio;
        if (tam == 0) return std::unexpected(Erro::rotulo_invalido);
        if (tam > 63) return std::unexpected(Erro::rotulo_longo);
        if (saida.size() + 1 + tam + 1 > 255) return std::unexpected(Erro::nome_longo);
        saida.push_back(static_cast<std::byte>(tam));
        for (std::size_t i = inicio; i < fim; ++i) {
            saida.push_back(static_cast<std::byte>(static_cast<unsigned char>(nome[i])));
        }
        if (ponto == std::string_view::npos) break;
        inicio = ponto + 1;
    }
    saida.push_back(std::byte{0});
    return saida;
}

std::expected<std::vector<std::byte>, Erro>
construir_consulta(std::string_view nome, std::uint16_t tipo,
                   std::uint16_t identificador) {
    auto u16 = [](std::vector<std::byte>& v, std::uint16_t x) {
        v.push_back(static_cast<std::byte>(x >> 8));
        v.push_back(static_cast<std::byte>(x & 0xFF));
    };
    std::vector<std::byte> m;
    u16(m, identificador);
    u16(m, 0x0100);  // RD = 1, o resolvedor recursivo faz o trabalho
    u16(m, 1);       // QDCOUNT
    u16(m, 0);       // ANCOUNT
    u16(m, 0);       // NSCOUNT
    u16(m, 0);       // ARCOUNT
    const auto q = codificar_nome(nome);
    if (!q) return std::unexpected(q.error());
    m.insert(m.end(), q->begin(), q->end());
    u16(m, tipo);
    u16(m, 1);       // QCLASS = IN
    return m;
}

// ---------- análise ----------

struct NomeLido {
    std::string nome;
    std::size_t proximo;  // deslocamento logo após o nome, no fluxo original
};

// Um ponteiro muda a origem dos bytes lidos, mas não muda onde o registro seguinte
// começa no fluxo original. O orçamento de saltos limita o trabalho mesmo quando
// uma mensagem malformada constrói um ciclo sem acrescentar caracteres ao nome.
std::expected<NomeLido, Erro> ler_nome(std::span<const std::byte> m, std::size_t off) {
    constexpr int  MAX_SALTOS = 16;
    constexpr std::size_t MAX_NOME = 255;

    std::string nome;
    std::size_t proximo = 0;
    bool saltou = false;
    int  saltos = 0;

    for (;;) {
        if (off >= m.size()) return std::unexpected(Erro::mensagem_curta);
        const auto b = static_cast<std::uint8_t>(m[off]);

        if ((b & 0xC0) == 0xC0) {                       // ponteiro
            if (off + 1 >= m.size()) return std::unexpected(Erro::mensagem_curta);
            if (++saltos > MAX_SALTOS) return std::unexpected(Erro::laco_de_ponteiros);
            const std::size_t alvo =
                (static_cast<std::size_t>(b & 0x3F) << 8) |
                 static_cast<std::uint8_t>(m[off + 1]);
            if (alvo >= m.size()) return std::unexpected(Erro::ponteiro_fora);
            if (!saltou) { proximo = off + 2; saltou = true; }
            off = alvo;
            continue;
        }
        if ((b & 0xC0) != 0x00) return std::unexpected(Erro::rotulo_invalido);
        if (b == 0) {                                   // fim do nome
            if (!saltou) proximo = off + 1;
            if (nome.empty()) nome = ".";
            return NomeLido{nome, proximo};
        }
        if (off + 1 + b > m.size()) return std::unexpected(Erro::mensagem_curta);
        if (nome.size() + b + 1 > MAX_NOME) return std::unexpected(Erro::nome_longo);
        if (!nome.empty()) nome.push_back('.');
        for (std::size_t i = 0; i < b; ++i) {
            nome.push_back(static_cast<char>(m[off + 1 + i]));
        }
        off += 1 + b;
    }
}

struct Registro {
    std::string   nome;
    std::uint16_t tipo{};
    std::uint32_t ttl{};
    std::string   valor;
};

struct Mensagem {
    std::uint16_t identificador{};
    std::uint16_t bandeiras{};
    std::string   pergunta;
    std::vector<Registro> respostas;
};

constexpr std::string_view nome_do_tipo(std::uint16_t t) {
    switch (t) {
        case 1:  return "A";
        case 2:  return "NS";
        case 5:  return "CNAME";
        case 15: return "MX";
        case 16: return "TXT";
        case 28: return "AAAA";
        default: return "?";
    }
}

std::expected<Mensagem, Erro> analisar(std::span<const std::byte> m) {
    auto u16 = [&](std::size_t o) -> std::uint16_t {
        return static_cast<std::uint16_t>(
            (static_cast<std::uint16_t>(std::to_integer<std::uint8_t>(m[o])) << 8) |
             static_cast<std::uint16_t>(std::to_integer<std::uint8_t>(m[o + 1])));
    };

    if (m.size() < 12) return std::unexpected(Erro::mensagem_curta);

    Mensagem msg;
    msg.identificador = u16(0);
    msg.bandeiras     = u16(2);
    const auto qd = u16(4);
    const auto an = u16(6);

    std::size_t off = 12;
    for (std::uint16_t i = 0; i < qd; ++i) {
        auto n = ler_nome(m, off);
        if (!n) return std::unexpected(n.error());
        msg.pergunta = n->nome;
        if (n->proximo > m.size() || m.size() - n->proximo < 4) {
            return std::unexpected(Erro::mensagem_curta);
        }
        off = n->proximo + 4;                            // QTYPE e QCLASS
    }

    for (std::uint16_t i = 0; i < an; ++i) {
        auto n = ler_nome(m, off);
        if (!n) return std::unexpected(n.error());
        off = n->proximo;
        if (off > m.size() || m.size() - off < 10) {
            return std::unexpected(Erro::mensagem_curta);
        }

        Registro r;
        r.nome = n->nome;
        r.tipo = u16(off);
        r.ttl  = (static_cast<std::uint32_t>(u16(off + 4)) << 16) | u16(off + 6);
        const auto rdlength = u16(off + 8);
        off += 10;
        if (off > m.size() || rdlength > m.size() - off) {
            return std::unexpected(Erro::mensagem_curta);
        }

        if (r.tipo == 1 && rdlength == 4) {
            r.valor = std::format("{}.{}.{}.{}",
                                  std::to_integer<int>(m[off]),     std::to_integer<int>(m[off + 1]),
                                  std::to_integer<int>(m[off + 2]), std::to_integer<int>(m[off + 3]));
        } else if (r.tipo == 5 || r.tipo == 2) {
            auto alvo = ler_nome(m, off);
            if (!alvo) return std::unexpected(alvo.error());
            if (alvo->proximo != off + rdlength) {
                return std::unexpected(Erro::rdata_invalida);
            }
            r.valor = alvo->nome;
        } else {
            r.valor = std::format("{} bytes de rdata", rdlength);
        }

        off += rdlength;
        msg.respostas.push_back(std::move(r));
    }
    return msg;
}

}  // namespace dns

namespace {

// Resposta sintética para www.example.com, com dois níveis de compressão.
// Os ponteiros reutilizam o nome da pergunta e o nome montado na RDATA anterior.
constexpr std::uint8_t RESPOSTA[] = {
    0x12, 0x34, 0x81, 0x80, 0x00, 0x01, 0x00, 0x02, 0x00, 0x00, 0x00, 0x00,
    0x03, 0x77, 0x77, 0x77, 0x07, 0x65, 0x78, 0x61, 0x6D, 0x70, 0x6C, 0x65,
    0x03, 0x63, 0x6F, 0x6D, 0x00, 0x00, 0x01, 0x00, 0x01, 0xC0, 0x0C, 0x00,
    0x05, 0x00, 0x01, 0x00, 0x00, 0x01, 0x2C, 0x00, 0x05, 0x02, 0x6C, 0x62,
    0xC0, 0x10, 0xC0, 0x2D, 0x00, 0x01, 0x00, 0x01, 0x00, 0x00, 0x00, 0x3C,
    0x00, 0x04, 0xCB, 0x00, 0x71, 0x0A,
};

// A mesma estrutura mínima, agora com um ponteiro que aponta para si mesmo.
constexpr std::uint8_t BOMBA[] = {
    0x12, 0x34, 0x81, 0x80, 0x00, 0x01, 0x00, 0x00, 0x00, 0x00, 0x00, 0x00,
    0xC0, 0x0C, 0x00, 0x01, 0x00, 0x01,
};

std::span<const std::byte> como_bytes(std::span<const std::uint8_t> v) {
    return {reinterpret_cast<const std::byte*>(v.data()), v.size()};
}

std::string em_hexa(std::span<const std::byte> v) {
    std::string s;
    s.reserve(v.size() * 3);
    for (const auto b : v) s += std::format("{:02X} ", std::to_integer<int>(b));
    return s;
}

}  // namespace

int main() {
    const auto consulta = dns::construir_consulta("www.example.com", 1, 0x1234);
    if (!consulta) {
        std::println("falha ao construir consulta: {}", dns::descrever(consulta.error()));
        return 1;
    }
    std::println("consulta: {} bytes", consulta->size());
    std::println("  {}", em_hexa(*consulta));

    const auto rotulo_longo = std::string(64, 'a') + ".example";
    const auto consulta_invalida = dns::construir_consulta(rotulo_longo, 1, 0x1234);
    std::println("consulta com rotulo de 64 bytes: {}",
                 consulta_invalida ? "aceita" : dns::descrever(consulta_invalida.error()));

    const auto msg = dns::analisar(como_bytes(RESPOSTA));
    if (!msg) {
        std::println("falha ao analisar: {}", dns::descrever(msg.error()));
        return 1;
    }

    std::println("");
    std::println("resposta: {} bytes, ID {:#06x}, RCODE {}",
                 sizeof(RESPOSTA), msg->identificador, msg->bandeiras & 0x0F);
    std::println("  pergunta: {}", msg->pergunta);
    for (const auto& r : msg->respostas) {
        std::println("  {:<16} {:<6} TTL {:>5} s  ->  {}",
                     r.nome, dns::nome_do_tipo(r.tipo), r.ttl, r.valor);
    }

    std::println("");
    const auto bomba = dns::analisar(como_bytes(BOMBA));
    std::println("mensagem com ponteiro circular: {}",
                 bomba ? "analisada" : std::format("recusada, {}", dns::descrever(bomba.error())));

    std::vector<std::uint8_t> rdata_ruim(RESPOSTA, RESPOSTA + sizeof(RESPOSTA));
    rdata_ruim[44] = 4;  // declara quatro bytes para um nome que ocupa cinco
    const auto registro_invasor = dns::analisar(como_bytes(rdata_ruim));
    std::println("rdata que invade o registro seguinte: {}",
                 registro_invasor ? "analisada"
                                  : std::format("recusada, {}",
                                                dns::descrever(registro_invasor.error())));
    return 0;
}
Compilado com MSVC 19.51 em /std:c++latest /utf-8 /W4 /WX /EHsc /O2, sem advertências, produz:
consulta: 33 bytes
  12 34 01 00 00 01 00 00 00 00 00 00 03 77 77 77 07 65 78 61 6D 70 6C 65 03 63 6F 6D 00 00 01 00 01
consulta com rotulo de 64 bytes: rotulo longo demais

resposta: 66 bytes, ID 0x1234, RCODE 0
  pergunta: www.example.com
  www.example.com  CNAME  TTL   300 s  ->  lb.example.com
  lb.example.com   A      TTL    60 s  ->  203.0.113.10

mensagem com ponteiro circular: recusada, laco de ponteiros
rdata que invade o registro seguinte: recusada, rdata invalida
Vale acompanhar a resposta byte a byte, porque a compressão só faz sentido quando se vê o ponteiro apontando.
A pergunta ocupa os deslocamentos $12$ a $32$, com www em $12$, example em $16$ e com em $24$. A primeira resposta começa em $33$ e seu nome é apenas C0 0C, isto é, um ponteiro para o deslocamento $12$. Assim, www.example.com inteiro cabe em dois bytes. Sua RDATA, em $45$, é 02 6C 62 C0 10: o rótulo lb seguido de um ponteiro para o deslocamento $16$, que monta lb.example.com em cinco bytes. O nome da segunda resposta é C0 2D, um ponteiro para o deslocamento $45$, e reutiliza o nome montado dentro da RDATA anterior.
A Figura 6 preserva a identidade de cada byte enquanto seguimos os três ponteiros. As caixas azuis pertencem ao nome original. As caixas violetas contêm as referências que voltam a posições já presentes na mensagem.
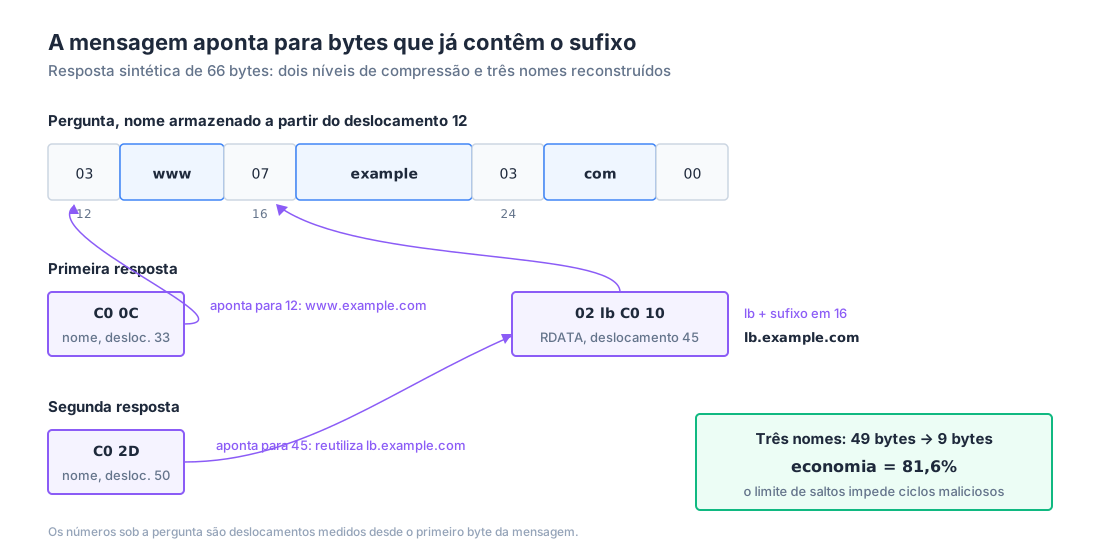 Figura 6: cada ponteiro reutiliza um sufixo que já aparece na mensagem. Os três nomes ocupam 9 bytes em vez de 49, mas o analisador precisa limitar saltos e respeitar as fronteiras de cada campo.
Sem compressão, esses três nomes ocupariam $17 + 16 + 16 = 49$ bytes. Com compressão, ocupam $2 + 5 + 2 = 9$. A economia é de $81{,}6\%$ nos nomes e de $37{,}7\%$ na mensagem inteira, que passaria de $106$ para os $66$ bytes observados. Em um serviço que responde a milhões de consultas por segundo, essa redução pode se tornar material para a largura de banda e para o processamento.
Quatro decisões do código merecem comentário.
codificar_nome devolve um erro antes de emitir um rótulo com mais de $63$ bytes ou um nome com mais de $255$. Sem essa verificação, um comprimento inválido poderia ocupar os dois bits reservados aos ponteiros e transformar uma consulta construída localmente em uma mensagem com outra estrutura. O programa exercita a fronteira com um rótulo de $64$ bytes e o recusa.
ler_nome devolve std::expected<NomeLido, Erro> porque falhar é o caso normal ao analisar dados de rede. Uma mensagem malformada não é uma condição excepcional: é o que um atacante envia de propósito, e a assinatura da função precisa dizer isso a quem a chama. O tipo obriga a lidar com o erro. Um código de retorno inteiro não oferece a mesma garantia.
O limite de saltos é a defesa contra a bomba de descompressão, e o programa o exercita: a constante BOMBA tem dezoito bytes e um ponteiro para si mesma, e o analisador a recusa em vez de girar. Registre que o limite precisa ser sobre o número de saltos, e não sobre o tamanho do nome: uma cadeia de ponteiros pode alternar entre dois pontos indefinidamente sem acrescentar um único caractere.
O campo proximo guarda o deslocamento seguinte no fluxo original e é atualizado apenas no primeiro salto. Sem isso, o chamador continuaria a leitura no lugar para onde o ponteiro apontou, não depois do ponteiro. Os registros seguintes seriam interpretados a partir de posições absurdas. É o tipo de defeito que deixa um analisador parecer correto até encontrar uma resposta comprimida de outra forma.
Por fim, um nome armazenado em RDATA precisa terminar exatamente no limite declarado por RDLENGTH. Verificar apenas se o nome cabe na mensagem permitiria que um rótulo malformado invadisse o registro seguinte. A checagem de rdata_invalida transforma esse limite do formato em uma condição explícita do analisador.
9.1 Exercícios da Seção 9
1. Codifique um nome no formato DNS
Codifique api.example.com. no formato de rótulos da RFC 1035 e calcule quantos bytes o nome ocupa, incluindo o terminador da raiz.
Solução: Os rótulos possuem comprimentos $3$, $7$ e $3$. Cada comprimento ocupa um byte, os caracteres ocupam $3+7+3=13$ bytes e a raiz ocupa o zero final.
03 61 70 69 07 65 78 61 6D 70 6C 65 03 63 6F 6D 00
   a  p  i     e  x  a  m  p  l  e     c  o  m
O tamanho será dado por
\[(1+3) + (1+7) + (1+3) + 1 = 17\ \text{bytes}.\]O ponto final não vira um caractere ponto na mensagem. Ele vira o rótulo raiz de comprimento zero, representado pelo último byte 00.
2. Decodifique dois ponteiros
Para um ponteiro de compressão, os dois bits superiores valem 11 e os catorze restantes carregam o deslocamento. Calcule os alvos de C0 0C e C0 2D.
Solução: O analisador remove os dois bits superiores do primeiro byte e concatena os catorze bits restantes:
\[o = ((b_0 \mathbin{\&} \mathtt{0x3F}) \ll 8) \mathbin{\vert} b_1.\]Para C0 0C, C0 & 3F = 00, portanto
Para C0 2D, o primeiro termo continua zero e 2D hexadecimal vale $2\times16+13=45$:
O primeiro ponteiro reutiliza www.example.com na pergunta. O segundo reutiliza lb.example.com dentro da RDATA anterior. A conta dos bits precisa concordar com as setas da Figura 6.
3. Confira a economia da compressão
Os três nomes da resposta ocupariam $17$, $16$ e $16$ bytes sem compressão e ocupam $2$, $5$ e $2$ bytes com os ponteiros. Calcule a economia percentual nos nomes e na mensagem inteira, que passa de $106$ para $66$ bytes.
Solução: Sem compressão, os nomes ocupam
\[17 + 16 + 16 = 49\ \text{bytes}.\]Com compressão, ocupam
\[2 + 5 + 2 = 9\ \text{bytes}.\]A economia nos nomes será dada por
\[\frac{49-9}{49} \times 100 = 81{,}63\%.\]Na mensagem inteira, a economia será
\[\frac{106-66}{106} \times 100 = 37{,}74\%.\]Os mesmos $40$ bytes foram removidos nos dois denominadores. O percentual muda porque os nomes são apenas uma parte da mensagem completa.
4. Rastreie o campo proximo
O nome da primeira resposta começa no deslocamento $33$ e contém apenas C0 0C. O ponteiro manda a leitura para $12$. Qual valor proximo deve ser devolvido ao chamador e por que não pode ser $33$ nem o final do nome apontado?
Solução: No fluxo original, o ponteiro ocupa os deslocamentos $33$ e $34$. O campo seguinte do registro começa em $35$, portanto
\[\text{proximo} = 33 + 2 = 35.\]O deslocamento $12$ serve para reconstruir os caracteres do nome. Ele não muda a posição física do tipo, da classe e do TTL da primeira resposta. Devolver $33$ faria o chamador reler o ponteiro. Devolver o final do nome armazenado na pergunta faria o chamador invadir os campos da pergunta. O analisador precisa manter dois percursos ao mesmo tempo: um para os caracteres e outro para a continuação do registro original.
5. Classifique três mensagens malformadas
Considere três entradas: um rótulo com comprimento $64$, um ponteiro que aponta para si mesmo e uma RDATA que declara quatro bytes, mas cujo nome comprimido ocupa cinco. Indique qual contrato cada caso viola e a resposta esperada do analisador.
Solução: Cada entrada ataca uma fronteira diferente.
| Entrada | Contrato violado | Resultado esperado |
|---|---|---|
| rótulo de $64$ bytes | os seis bits de comprimento admitem no máximo $63$ | rotulo_longo |
| ponteiro circular | o trabalho precisa terminar dentro do orçamento de saltos | laco_de_ponteiros |
nome de cinco bytes em RDLENGTH=4 |
a RDATA não pode invadir o campo seguinte |
rdata_invalida |
Verificar apenas o tamanho total da mensagem não detectaria o terceiro caso, e verificar apenas o tamanho do nome não detectaria o ciclo. Um analisador de entrada hostil precisa impor o limite específico de cada estrutura, porque mensagens pequenas também podem consumir trabalho ilimitado ou atravessar fronteiras internas.
O laboratório abaixo põe em movimento a aritmética das Seções 3 e 6. Vale começar pelas configurações predefinidas e depois arrastar o TTL, observando ao mesmo tempo a taxa de acerto do cache, a carga no autoritativo e o limite de recuperação.
Quando o Lab 03 da suíte NetworkLabs estiver disponível, o experimento a fazer nele é outro e complementar: derrubar o servidor autoritativo e cronometrar por quanto tempo os clientes continuam funcionando apenas por causa do cache. É o compromisso da Seção 3 visto do lado bom.
10. Como auditar uma mudança de DNS
Uma mudança de DNS precisa ser verificada no arquivo de zona, na resolução observada de fora e no tempo necessário para desfazê-la. Considere a configuração abaixo para apontar um domínio a um balanceador de carga:
Para apontar o domínio raiz para o balanceador de carga, crie um registro CNAME no ápice da zona:
example.com. 300 IN CNAME lb-prod-1234.elb.amazonaws.com.Isso garante que, se o endereço IP do balanceador de carga mudar, a resolução continuará funcionando sem necessidade de alteração na zona.
O objetivo operacional está certo, mas a configuração é proibida. A RFC 1034 não permite que um CNAME coexista com outros registros no mesmo nó, e o ápice é obrigado a conter SOA e NS.
O que torna esse erro perigoso é o comportamento das ferramentas. Alguns provedores recusam o registro, e o problema aparece na hora, que é o melhor caso. Outros aceitam e o convertem silenciosamente em um ALIAS, o que funciona e produz uma semântica diferente da pedida, com TTL efetivo decidido pelo provedor. Um servidor autoritativo próprio pode até aceitar o arquivo de zona e servir respostas inconsistentes, interpretadas de formas diferentes pelos resolvedores. O mesmo erro tem três desfechos conforme a ferramenta, e apenas um deles avisa.
O verificador, em três camadas.
A sintaxe é a validação do arquivo de zona ou da chamada de API. Um verificador de zona detecta o CNAME no ápice, registros duplicados, TTLs fora de faixa e nomes malformados. É barato, pode ser automatizado em uma esteira de integração contínua e impede que muitos disparates cheguem ao provedor. O Artigo 9 transformará essa verificação em um portão de integração.
A semântica aparece na resolução observada de fora. Precisamos consultar o nome por pelo menos três resolvedores independentes e comparar cada resposta com o valor esperado. Um deles pode estar servindo um cache antigo e concordar pelo motivo errado. Por isso, verificamos o valor, o tipo, o código da resposta, a autoridade e o TTL devolvido, que nem sempre coincide com o número digitado na interface do provedor.
O alcance do impacto de uma falha tem uma característica temporal própria no DNS. Aplicar uma mudança errada leva segundos, mas retirar uma resposta já armazenada pode levar um TTL inteiro. Com TTL de $3600$ s, um resolvedor que recebeu o valor errado às 9h00 pode conservá-lo até 10h00, mesmo que a correção seja publicada às 9h01. Sob a hipótese de atualizações uniformemente distribuídas, apenas cerca de $1/60$ dos resolvedores buscaria a resposta durante esse minuto. A população afetada seria pequena, mas persistente e difícil de reproduzir. A pergunta antes da alteração passa a ser: se estiver errado, quanto tempo levaremos para reverter e quantos usuários atravessarão esse intervalo?
10.1 Exercícios da Seção 10
1. Encontre três defeitos em um plano de migração
Considere o plano abaixo para migrar um serviço entre regiões. Identifique os três defeitos e apresente a sequência corrigida.
- Reduzir o TTL do registro de 3600s para 60s.
- Imediatamente após, alterar o registro A para o novo endereço.
- Aguardar 60 segundos para a propagação completa.
- Validar acessando o domínio pelo navegador e confirmando que a nova versão responde.
Solução: O primeiro defeito está no passo 2. Reduzir o TTL não afeta as cópias já armazenadas, que carregam o valor anterior com o TTL anterior. Alterar o registro imediatamente depois permite que parte dos resolvedores continue servindo o endereço antigo por até $3600$ s. É preciso esperar o TTL anterior inteiro entre a redução e a troca do endereço, exatamente como o exercício 4 da Seção 3 estabeleceu.
O segundo defeito é uma etapa ausente depois do passo 4. O plano reduz o TTL para $60$ s e nunca o restaura. A migração termina funcionalmente, mas deixa o autoritativo recebendo até sessenta vezes mais consultas que na configuração original de $3600$ s. Um valor transitório não deve virar custo permanente.
O terceiro defeito está no passo 4. Testar pelo navegador da operadora verifica um caminho, com um resolvedor e com os caches locais daquela máquina, provavelmente preenchidos durante a preparação. A validação correta consulta o nome por resolvedores independentes e compara o valor, o tipo e o TTL.
| Ordem corrigida | Ação | Espera ou verificação |
|---|---|---|
| 1 | reduzir o TTL de $3600$ para $60$ s | esperar $3600$ s |
| 2 | alterar o registro | registrar o instante da mudança |
| 3 | observar resolvedores independentes | esperar até $60$ s para caches conformes atualizados |
| 4 | validar a aplicação nos destinos | comparar requisições, erros e versão atendida |
| 5 | restaurar o TTL | confirmar a queda esperada de consultas autoritativas |
O plano corrigido trata configuração, resolução externa e comportamento da aplicação como evidências diferentes. Nenhuma delas substitui as outras duas.
2. Calcule a população atingida por uma resposta errada
Cem mil resolvedores atualizam um registro uniformemente ao longo de um TTL de $3600$ s. A equipe publica um endereço errado às 9h00 e o corrige às 9h01. Estime quantos resolvedores podem ter buscado o valor errado nesse minuto e até quando os últimos podem conservá-lo.
Solução: A fração que atualiza durante um minuto de uma janela de sessenta minutos será dada por
\[f = \frac{60}{3600} = \frac{1}{60} = 1{,}6667\%.\]O número esperado de resolvedores afetados é
\[100\,000 \times \frac{1}{60} = 1666{,}67.\]Esperamos, portanto, cerca de $1667$ resolvedores com a resposta errada. Os que a receberam perto das 9h00 podem mantê-la até perto das 10h00. Os que a receberam perto das 9h01 podem mantê-la até perto das 10h01.
A correção rápida limitou a população exposta a cerca de $1{,}67\%$, mas não encurtou o TTL já entregue a essa população. Poucos usuários podem continuar falhando durante uma hora, o tipo de incidente que desaparece quando testado apenas pela máquina da equipe.
3. Construa uma matriz de validação externa
Uma migração deve trocar api.example.com de 203.0.113.10 para 203.0.113.20, mantendo o tipo A e um TTL configurado de $60$ s. Três resolvedores devolvem os dados abaixo. Classifique o estado da propagação.
| Resolvedor | Tipo | Valor | TTL observado |
|---|---|---|---|
| R1 | A |
203.0.113.20 |
$48$ s |
| R2 | A |
203.0.113.10 |
$12$ s |
| R3 | CNAME |
api.vendor.example |
$300$ s |
Solução: R1 já recebeu o valor novo e apresenta um TTL remanescente plausível. R2 ainda conserva o valor antigo, mas seu TTL de $12$ s indica que a entrada se aproxima da expiração. R3 não mostra apenas um cache atrasado. Ele devolve outro tipo e outro contrato, o que sugere uma divergência de configuração, uma visão dividida da zona ou um caminho que consulta outro provedor.
| Resolvedor | Classificação | Próxima ação |
|---|---|---|
| R1 | convergiu | verificar novamente após a janela |
| R2 | cache antigo ainda válido | aguardar pelo menos $12$ s e repetir |
| R3 | divergência semântica | rastrear a autoridade e a configuração atendida |
Uma validação que compare apenas se houve resposta classificaria os três como saudáveis. Comparar tipo, valor e TTL transforma a consulta em evidência sobre o estado real da mudança.
4. Dimensione o orçamento de reversão
Uma alteração usa TTL de $300$ s. A detecção automatizada leva no pior caso $40$ s, a decisão humana leva $120$ s e a publicação da reversão leva $20$ s. Calcule quando a correção chega ao autoritativo e o limite para um resolvedor que buscou a resposta errada imediatamente antes da reversão.
Solução: O tempo até publicar a reversão será dado por
\[T_{\text{publicação}} = 40 + 120 + 20 = 180\ \text{s}.\]Um resolvedor que recebe a resposta errada no instante $179$ pode conservá-la por mais $300$ s. Seu limite após o início do incidente será
\[T_{\text{cliente}} = 179 + 300 = 479\ \text{s}.\]Isso corresponde a $7$ minutos e $59$ segundos. A reversão autoritativa termina em três minutos, mas a experiência de uma parte dos clientes pode permanecer errada por quase oito minutos. O orçamento operacional precisa incluir publicação e expiração, não apenas o tempo da equipe até apertar o botão de reversão.
| Fronteira observada | Instante limite desde o início |
|---|---|
| correção publicada no autoritativo | $180$ s, ou $3$ min |
| último cliente do cenário deixa de usar a resposta errada | $479$ s, ou $7$ min $59$ s |
A diferença de $299$ s pertence ao TTL entregue antes da reversão. A tabela separa o momento em que a configuração fica correta do momento em que o último cliente do cenário deixa de observar o erro.
5. Audite um lançamento depois de uma resposta negativa
Durante os testes, novo.example.com respondeu NXDOMAIN às 13h00 com TTL negativo de $600$ s. O registro é criado às 13h02 e o lançamento está marcado para 13h05. Determine o risco e proponha uma correção verificável.
Solução: A resposta negativa pode permanecer válida até
\[13\text{h}00 + 600\ \text{s} = 13\text{h}10.\]No lançamento das 13h05, um resolvedor que guardou o NXDOMAIN ainda pode negar o nome por cinco minutos. Criar o registro não invalida essa ausência.
A correção segura é adiar o lançamento até depois de 13h10 e consultar o nome por resolvedores independentes antes de liberar tráfego. Em lançamentos futuros, a equipe pode publicar antecipadamente um registro válido com o destino controlado ou reduzir o TTL negativo da zona com antecedência suficiente. O objeto da auditoria não é apenas o registro criado. É também a ausência que já foi distribuída.
11. Questões no estilo ENADE
Resolução recursiva, delegação, registros, TTL, cache negativo, DNSSEC e distribuição global compõem um sistema cheio de estados intermediários. O questionário a seguir reúne cinco questões no estilo ENADE para testar o raciocínio necessário para operar esse sistema. As respostas permanecem ocultas até o final. Depois da última questão, o resultado separa acertos e erros e explica cada alternativa incorreta escolhida.
12. Conclusão
Este artigo tratou de um sistema que quase todo mundo considera resolvido e pouca gente sabe dimensionar.
A leitora agora calcula a taxa de acerto do cache por $h = \lambda T/(1 + \lambda T)$ e sabe que ela depende do produto $\lambda T$, não do TTL isolado. Sob expirações uniformemente distribuídas, a fração desatualizada cai linearmente e chega a zero no próprio TTL. Por isso, uma migração planejada precisa esperar o valor anterior expirar antes da troca. Reduzir o TTL por dez multiplica por dez a carga no autoritativo, enquanto a fatura segue os degraus da tarifa. O cache negativo obedece à mesma lógica e pode ocultar um nome recém-criado.
Também separamos os $93$ ms de uma resolução com caches vazios, os $3$ ms de uma resposta no cache do resolvedor e o valor inferior a $1$ ms de um cache local. O custo de uma cadeia de CNAME depende das delegações já conhecidas. Pesos governam respostas autoritativas, não porcentagens de requisições. Por isso, a exposição de uma implantação canário precisa ser medida nos destinos.
A soma entre detecção e TTL é um limite construído para o pior caso, não uma observação automática de todo cliente. Camadas compatíveis preservam o TTL remanescente. Somente uma política local que estenda esse valor cria tempo adicional. DNSSEC autentica origem e integridade por uma cadeia que começa em uma âncora conhecida, mas não cifra a consulta nem impede uma negação de serviço.
Resta a conclusão operacional. O alcance do impacto de uma falha no DNS é assimétrico no tempo: publicar leva segundos, enquanto retirar uma resposta já armazenada depende de expiração. A reversão termina no plano autoritativo antes de terminar para todos os clientes.
Um fio ficou solto de propósito. A Seção 7 mencionou um incidente em que servidores autoritativos perfeitamente saudáveis desapareceram da Internet porque uma alteração de configuração retirou os anúncios de rota dos prefixos que os continham. Nada no formato DNS falhou. Falhou a camada que decide por onde os pacotes vão. O próximo artigo entra no BGP e mostra como políticas entre organizações propagam anúncios de alcance sem que o protocolo-base forneça prova criptográfica da origem de cada rota.
Acrônimos e Abreviações neste artigo
| Acrônimo | Definição em Inglês | Tradução em Português |
|---|---|---|
API |
Application Programming Interface | Interface de Programação de Aplicações |
BGP |
Border Gateway Protocol | Protocolo de Roteamento de Borda |
DNS |
Domain Name System | Sistema de Nomes de Domínio |
DNSSEC |
Domain Name System Security Extensions | Extensões de Segurança do DNS |
DS |
Delegation Signer | Signatário da Delegação |
DoH |
DNS over HTTPS | DNS sobre HTTPS |
DoT |
DNS over TLS | DNS sobre TLS |
FQDN |
Fully Qualified Domain Name | Nome de Domínio Plenamente Qualificado |
IN |
Internet (classe de registro) | Internet |
MTU |
Maximum Transmission Unit | Unidade Máxima de Transmissão |
PoP |
Point of Presence | Ponto de Presença |
QUIC |
QUIC (nome próprio) | QUIC |
RDATA |
Resource Data | Dados do Registro |
RFC |
Request for Comments | Pedido de Comentários |
RRSIG |
Resource Record Signature | Assinatura de Conjunto de Registros |
RTT |
Round-Trip Time | Tempo de Ida e Volta |
SOA |
Start of Authority | Início de Autoridade |
TCP |
Transmission Control Protocol | Protocolo de Controle de Transmissão |
TLD |
Top-Level Domain | Domínio de Topo |
TLS |
Transport Layer Security | Segurança da Camada de Transporte |
TTL |
Time To Live | Tempo de Vida |
UDP |
User Datagram Protocol | Protocolo de Datagrama de Usuário |
Referências
AMAZON WEB SERVICES. Amazon Route 53 Developer Guide: Choosing a Routing Policy. Disponível em: https://docs.aws.amazon.com/Route53/latest/DeveloperGuide/routing-policy.html. Acesso em: 12 set. 2026.
AMAZON WEB SERVICES. Amazon Route 53 Pricing. Disponível em: https://aws.amazon.com/route53/pricing/. Acesso em: 12 set. 2026.
AMAZON WEB SERVICES. Choosing Between Alias and Non-Alias Records. Disponível em: https://docs.aws.amazon.com/Route53/latest/DeveloperGuide/resource-record-sets-choosing-alias-non-alias.html. Acesso em: 12 set. 2026.
AMAZON WEB SERVICES. Values Specific for Weighted Records. Disponível em: https://docs.aws.amazon.com/Route53/latest/DeveloperGuide/resource-record-sets-values-weighted.html. Acesso em: 12 set. 2026.
ANDREWS, M. RFC 2308: Negative Caching of DNS Queries (DNS NCACHE). IETF, 1998. Disponível em: https://www.rfc-editor.org/rfc/rfc2308. Acesso em: 12 set. 2026.
ANDREWS, M.; HUQUE, S.; WOUTERS, P.; WESSELS, D. RFC 9471: DNS Glue Requirements in Referral Responses. IETF, 2023. Disponível em: https://www.rfc-editor.org/rfc/rfc9471. Acesso em: 12 set. 2026.
ARENDS, R.; AUSTEIN, R.; LARSON, M.; MASSEY, D.; ROSE, S. RFC 4033: DNS Security Introduction and Requirements. IETF, 2005. Disponível em: https://www.rfc-editor.org/rfc/rfc4033. Acesso em: 12 set. 2026.
CLOUDFLARE. Understanding How Facebook Disappeared from the Internet. The Cloudflare Blog, 2021. Disponível em: https://blog.cloudflare.com/october-2021-facebook-outage/. Acesso em: 12 set. 2026.
CONTAVALLI, C.; VAN DER GAAST, W.; LAWRENCE, D.; KUMARI, W. RFC 7871: Client Subnet in DNS Queries. IETF, 2016. Disponível em: https://www.rfc-editor.org/rfc/rfc7871. Acesso em: 12 set. 2026.
DICKINSON, J.; DICKINSON, S.; BELLIS, R.; MANKIN, A.; WESSELS, D. RFC 7766: DNS Transport over TCP: Implementation Requirements. IETF, 2016. Disponível em: https://www.rfc-editor.org/rfc/rfc7766. Acesso em: 12 set. 2026.
DYN. Dyn Statement on 10/21/2016 DDoS Attack. 2016. Disponível em: https://cyber-peace.org/wp-content/uploads/2016/10/Dyn-Statement-on-10_21_2016-DDoS-Attack.pdf. Acesso em: 12 set. 2026.
ELZ, R.; BUSH, R. RFC 2181: Clarifications to the DNS Specification. IETF, 1997. Disponível em: https://www.rfc-editor.org/rfc/rfc2181. Acesso em: 12 set. 2026.
FUJIWARA, K.; VIXIE, P. RFC 9715: IP Fragmentation Avoidance in DNS over UDP. IETF, 2025. Disponível em: https://www.rfc-editor.org/rfc/rfc9715. Acesso em: 12 set. 2026.
HOFFMAN, P.; MCMANUS, P. RFC 8484: DNS Queries over HTTPS (DoH). IETF, 2018. Disponível em: https://www.rfc-editor.org/rfc/rfc8484. Acesso em: 12 set. 2026.
HU, Z.; ZHU, L.; HEIDEMANN, J.; MANKIN, A.; WESSELS, D.; HOFFMAN, P. RFC 7858: Specification for DNS over Transport Layer Security (TLS). IETF, 2016. Disponível em: https://www.rfc-editor.org/rfc/rfc7858. Acesso em: 12 set. 2026.
INTERNET SYSTEMS CONSORTIUM. BIND 9 Administrator Reference Manual. Disponível em: https://bind9.readthedocs.io/. Acesso em: 12 set. 2026.
MOCKAPETRIS, P. RFC 1034: Domain Names: Concepts and Facilities. IETF, 1987. Disponível em: https://www.rfc-editor.org/rfc/rfc1034. Acesso em: 12 set. 2026.
MOCKAPETRIS, P. RFC 1035: Domain Names: Implementation and Specification. IETF, 1987. Disponível em: https://www.rfc-editor.org/rfc/rfc1035. Acesso em: 12 set. 2026.
ROOT SERVER TECHNICAL OPERATIONS ASSOCIATION. Root Server Technical Operations. Disponível em: https://root-servers.org/. Acesso em: 12 set. 2026.
VIXIE, P.; DAMAS, J.; GRAFF, M.; KOLKMAN, O. RFC 6891: Extension Mechanisms for DNS (EDNS(0)). IETF, 2013. Disponível em: https://www.rfc-editor.org/rfc/rfc6891. Acesso em: 12 set. 2026.
Índice da Série: Redes para Engenharia de Software
- 1. A Pilha TCP/IP e a Física da Rede
- 2. Da Rede Local à Web: Dispositivos, Topologias e Serviços
- 3. Camada de Internet: IP, Endereçamento, Sub-redes e Encaminhamento
- 4. Transporte: TCP, UDP e QUIC
- 5. Resolução de Nomes: DNS na Era da Nuvem (Você está aqui)
(Updated: )